Startseite
» Technologie
»
Was verursacht flächendeckende Ausfälle von Cloud-Plattformen? Die Fehlermuster hinter größeren Ausfällen.
Was verursacht flächendeckende Ausfälle von Cloud-Plattformen? Die Fehlermuster hinter größeren Ausfällen.
Weitreichende Ausfallzeiten von Cloud-Plattformen entstehen selten dadurch, dass ein einzelner Server einfach „ausfällt“. Die gravierendsten Vorfälle beginnen in der Regel mit einem technischen Fehler – einer fehlerhaften Konfiguration, einem Softwaredefekt, einem DNS-Problem, einem Netzwerkausfall oder einem Infrastrukturereignis – und breiten sich dann aus, da viele Dienste von denselben Steuerungsebenen, Datenbanken, Identitätssystemen, Load Balancern oder regionalen Ressourcen abhängen.
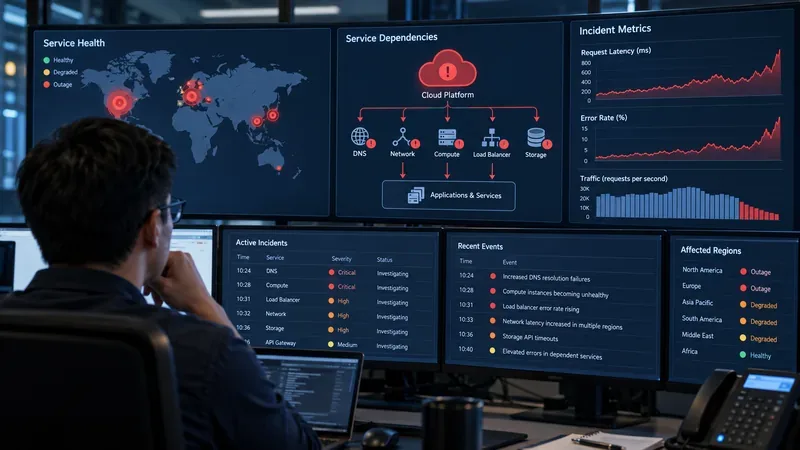
Beispiel: Stellen Sie sich einen fiktiven Cloud-Anbieter namens Northstar Cloud vor. Um 10:05 Uhr wird eine automatische Netzwerkänderung an einem regionalen Dienst vorgenommen. Innerhalb weniger Minuten melden Kunden fehlgeschlagene API-Aufrufe. Um 10:12 Uhr lassen sich keine neuen virtuellen Maschinen mehr starten. Um 10:20 Uhr beginnen Load Balancer, funktionierende Backends als nicht verfügbar zu kennzeichnen. Bis 10:35 Uhr sind Dutzende scheinbar unabhängige Produkte beeinträchtigt. Dieses Szenario ist hypothetisch und beschreibt keinen realen Ausfall. Es ist jedoch hilfreich, da es verdeutlicht, wie ein kleiner anfänglicher Fehler zu einem schwerwiegenden Plattformausfall führen kann.
Cloud-Betriebsteams müssen häufig einen Ausfall von der ersten fehlerhaften Abhängigkeit über DNS, Netzwerk, Rechenleistung, Lastverteilung, Speicher bis hin zu nachgelagerten Anwendungen zurückverfolgen.
Die kurze Antwort: Größere Cloud-Ausfälle sind in der Regel kaskadierende Ausfälle.
Die Hauptursachen für weitverbreitete Ausfallzeiten von Cloud-Plattformen sind Konfigurations- und Bereitstellungsfehler, latente Softwaredefekte, DNS- und Routing-Fehler, Abhängigkeiten von gemeinsam genutzten Diensten, Kapazitätsengpässe während eines Ausfalls oder der Wiederherstellung, Probleme der Steuerungsebene sowie physische Ausfälle, die ein Rechenzentrum oder eine Verfügbarkeitszone betreffen. Das Ausmaß des Ausfalls hängt weniger vom ersten Fehler ab als vielmehr davon, wie weit verbreitet die betroffene Komponente genutzt wird.
Ein hilfreiches Praxisbeispiel liefert AWS. In der offiziellen Zusammenfassung des Vorfalls im Oktober 2025 in Nord-Virginia gab AWS an, dass eine latente Race Condition im automatisierten DNS-Managementsystem von DynamoDB einen fehlerhaften, leeren DNS-Eintrag für den regionalen Endpunkt erzeugte. Dieser DNS-Fehler beeinträchtigte Kunden und interne AWS-Dienste, die von DynamoDB abhängig waren. Die anschließenden Wiederherstellungsmaßnahmen führten zu Problemen beim Starten von EC2-Instanzen und bei Network Load Balancern. Der Vorfall ist in der AWS-Zusammenfassung des DynamoDB-Vorfalls vom Oktober 2025 dokumentiert .
1. Konfigurationsänderungen können einen unerwartet großen Explosionsradius erzeugen.
Konfigurationsfehler zählen zu den häufigsten Fehlern bei Störungen in großen verteilten Systemen, da moderne Plattformen automatisiert gesteuert werden. Eine einzelne Änderung kann schneller auf Tausende von Hosts, Routern, DNS-Einträgen oder Service-Endpunkten übertragen werden, als ein menschlicher Bediener sie manuell bearbeiten könnte.
Kehren wir zum Northstar-Cloud-Szenario zurück. Angenommen, die Netzwerkänderung um 10:05 Uhr war für zehn Maschinen vorgesehen, wurde aber auf mehrere Regionen angewendet. Die Änderung muss keine Hardware zerstören. Sie kann lediglich die nutzbare Netzwerkkapazität reduzieren, das Routing verändern oder dazu führen, dass Systeme ansonsten einwandfreien Datenverkehr ablehnen. Sobald die gemeinsam genutzte Kapazität unter den Bedarf sinkt, kommt es bei Kunden zu Timeouts und Wiederholungsversuchen, was die Last zusätzlich erhöht.
Google beschrieb einen ähnlichen Mechanismus in seinem offiziellen Bericht zu einer Störung im Jahr 2019: Eine Konfigurationsänderung, die für wenige Server in einer Region gedacht war, wurde fälschlicherweise viel umfassender angewendet, wodurch mehrere Regionen mehr als die Hälfte ihrer verfügbaren Netzwerkkapazität nicht mehr nutzen konnten. Der Datenverkehr führte dann zu einer Überlastung der verbleibenden Kapazität. Siehe Googles offizielles Update zur Servicestörung von 2019 .
Aus diesem Grund setzen erfahrene Cloud-Betreiber auf gestaffelte Rollouts, Validierung, automatisiertes Rollback, Änderungsratenbegrenzungen und Maßnahmen zur Begrenzung der Auswirkungen. Diese Sicherheitsvorkehrungen verhindern zwar keine Vorfälle, können aber verhindern, dass eine fehlerhafte Änderung zu einem plattformweiten Problem wird.
2. Softwarefehler können so lange unentdeckt bleiben, bis seltene Zeitbedingungen eintreten.
Große Cloud-Plattformen betreiben riesige Flotten verteilter Software. Manche Fehler bleiben monate- oder jahrelang unentdeckt, da sie eine seltene Abfolge von Ereignissen erfordern: zwei Controller, die denselben Zustand aktualisieren, eine ungewöhnliche Verzögerung, veraltete Metadaten oder ein Wiederherstellungsprozess, der gleichzeitig mit einem Bereinigungsprozess ausgeführt wird.
Im fiktiven Northstar-Vorfall aktualisieren zwei unabhängige Automatisierungsprozesse denselben DNS-Plan. Einer verzögert sich, der andere führt eine neuere Aktualisierung durch, und eine Bereinigungsroutine entfernt anschließend die Daten, die der verzögerte Prozess gerade aktiviert hat. Jede einzelne Komponente scheint zwar wie vorgesehen zu funktionieren, doch ihre Interaktion führt zu einem ungültigen Zustand.
Das AWS-DynamoDB-Ereignis von 2025 verdeutlicht diese Kategorie. AWS führte den ursprünglichen Fehler auf eine latente Race Condition zwischen redundanten DNS-Management-Komponenten zurück. Die Bedeutung reicht über einen einzelnen Anbieter hinaus: Redundanz verbessert die Zuverlässigkeit nur dann, wenn redundante Komponenten den gemeinsamen Zustand nicht durch denselben Logik- oder Synchronisierungsfehler beschädigen können.
3. DNS- und Netzwerkfehler können dazu führen, dass intakte Systeme nicht mehr erreichbar sind.
Ein Dienst kann vollständig eingeschaltet sein und dennoch praktisch nicht verfügbar sein, wenn Kunden seinen Hostnamen nicht auflösen können oder Pakete ihn nicht erreichen. DNS, Routing, Load Balancing und Netzwerkkonfiguration sind daher für nahezu jedes Cloud-Produkt kritisch.
In unserem Northstar-Beispiel könnten Kunden annehmen, dass der Compute-Service selbst ausgefallen ist, weil API-Aufrufe ein Timeout verursachen. Die Compute-Server könnten jedoch einwandfrei funktionieren, während DNS keinen nutzbaren Endpunkt liefert, eine Route fehlt oder ein Load Balancer funktionierende Ziele entfernt hat.
AWS hat diesen Fehlermodus bereits mehrfach dokumentiert. Bei einem Vorfall in der Region Seoul im Jahr 2018 gab AWS an, dass ein Konfigurationsupdate fälschlicherweise eine Einstellung entfernt hatte, die die Mindestanzahl fehlerfreier Hosts für die EC2-DNS-Resolver-Flotte festlegte. Die dadurch reduzierte Resolver-Kapazität führte dazu, dass DNS-Anfragen von EC2-Instanzen fehlschlugen. Die Details finden sich in der AWS-Zusammenfassung des EC2-DNS-Auflösungsproblems von 2018 in Seoul .
Netzwerkfehler verstärken sich zudem schnell, da Anwendungen fehlgeschlagene Verbindungen erneut versuchen. Ein aggressives Wiederholungsverhalten kann eine partielle Netzwerkbeeinträchtigung in einen deutlich größeren Datenverkehrsanstieg verwandeln.
4. Gemeinsame Abhängigkeiten führen dazu, dass unabhängige Dienste gleichzeitig ausfallen.
Cloud-Dienste sind keine isolierten Produkte. Eine verwaltete Datenbank kann von Identitätsdiensten, internem DNS, Speicher, Netzwerk, Scheduling-Systemen, Zertifikatsdiensten und Telemetrie abhängig sein. Eine serverlose Plattform kann Rechenkapazität, Netzwerk, Warteschlangen und Datenbanken der Steuerungsebene benötigen. Fällt eine dieser gemeinsamen Abhängigkeiten aus, können viele Produkte gleichzeitig beeinträchtigt werden.
Dies erklärt eines der verwirrendsten Ausfallsymptome: Kunden bemerken Fehler in mehreren Diensten und gehen davon aus, dass mehrere unabhängige Ausfälle aufgetreten sind. In Wirklichkeit können die sichtbaren Ausfälle jedoch alle dieselbe Ursache im vorgelagerten System haben.
Im Northstar-Szenario könnten der virtuelle Maschinendienst, der Containerdienst und der Serverless-Dienst ausfallen, da sie alle auf dieselbe interne Ressourcendatenbank zugreifen. Die kundenseitigen Produkte sind unterschiedlich; die zugrunde liegende Abhängigkeit jedoch nicht.
Der AWS-Vorfall vom Oktober 2025 verdeutlichte diese Art von Kaskade, als interne Dienste, die auf DynamoDB angewiesen waren, von dem ursprünglichen DNS-Problem betroffen waren, gefolgt von nachgelagerten Wiederherstellungseffekten bei EC2, Network Load Balancer, Lambda, Containerdiensten, identitätsbezogenen Funktionen und anderen Produkten.
5. Die Wiederherstellung kann fehlschlagen, weil der Rückstand größer ist als die normale Betriebslast.
Die Wiederherstellung der ursprünglich fehlerhaften Komponente behebt einen Ausfall nicht immer. Während der Ausfallzeit wachsen Warteschlangen, Leases laufen ab, Integritätsprüfungen schlagen fehl, Autoscaler fordern Ersatzkapazität an, Clients wiederholen Anfragen und Konfigurationsaktualisierungen häufen sich an. Sobald die ausgefallene Komponente wieder verfügbar ist, versuchen möglicherweise alle wartenden Systeme gleichzeitig, sich zu erholen.
Nehmen wir im Northstar-Beispiel an, dass das DNS um 10:45 Uhr repariert wird. Tausende von Compute-Hosts versuchen nun, abgelaufene Leases zu verlängern. Gleichzeitig wiederholen Kunden fehlgeschlagene Deployments, und Autoscaling-Systeme fordern Ersatzinstanzen an. Die Steuerungsebene verarbeitet plötzlich ein Vielfaches ihrer normalen Arbeitslast. Ohne effektive Ratenbegrenzungen oder Priorisierung der Wiederherstellung kann sie in einen zweiten Fehlermodus wechseln, obwohl der ursprüngliche Fehler behoben ist.
AWS beschrieb 2025 ein vergleichbares Wiederherstellungsproblem: Nachdem der Zugriff auf DynamoDB wiederhergestellt war, musste ein EC2-Subsystem eine große Anzahl von Leases neu einrichten. Der Rückstand konnte vor dem Auftreten von Timeouts nicht mehr abgearbeitet werden, und AWS erklärte, das Subsystem sei in einen Zustand des „Überlastungszusammenbruchs“ geraten. Dieses Detail ist wichtig, da es verdeutlicht, warum die Ausfalldauer deutlich länger sein kann als die Zeit, die zur Behebung der ursprünglichen Ursache benötigt wird.
6. Gesundheitsprüfungen und automatisches Failover können manchmal gute Kapazitäten abbauen.
Systemprüfungen sind unerlässlich, treffen aber auch automatisierte Entscheidungen. Ist ein Netzwerk langsam oder verzögert sich die Statusweitergabe, kann ein solches System fälschlicherweise annehmen, dass eigentlich funktionierende Ressourcen fehlerhaft sind, und sie außer Betrieb nehmen. Dies kann die Kapazität weiter reduzieren und einen Teufelskreis auslösen.
Im fiktiven Szenario beginnen die Load Balancer von Northstar mit der Überprüfung neu gestarteter Instanzen, bevor die Netzwerkkonfiguration vollständig propagiert wurde. Die Überprüfungen schlagen fehl, fehlerfreie Instanzen werden entfernt, der Datenverkehr verteilt sich auf die verbleibenden Knoten, und diese werden überlastet.
Dieses Muster zeigte sich auch beim AWS-Event 2025. AWS gab an, dass die Integritätsprüfungen des Network Load Balancers mitunter fehlschlugen, solange der Netzwerkstatus für neue Instanzen noch nicht vollständig aktualisiert war. Dies führte dazu, dass Kapazitäten aus dem Dienst entfernt wurden. Dies verdeutlicht, dass die Failover-Logik nicht nur unter einwandfreien „gesunden/ungesunden“ Bedingungen, sondern auch unter Teilausfallbedingungen ratenbegrenzt und getestet werden muss.
7. Ausfälle des Rechenzentrums, der Stromversorgung, der Kühlung und der Verfügbarkeitszone sind weiterhin möglich.
Nicht jeder Ausfall hat seinen Ursprung in der Software. Stromversorgung, Kühlung, Glasfaser, Netzwerkhardware und andere physische Infrastrukturen können ausfallen. Die Cloud-Architektur ist auf diese Realität ausgelegt, weshalb große Anbieter Regionen in ausfallsichere Zonen unterteilen.
Microsoft erklärt, dass Azure-Verfügbarkeitszonen voneinander getrennte Gruppen von Rechenzentren mit unabhängiger Stromversorgung, Kühlung und Netzwerkverbindung sind. Microsoft weist außerdem darauf hin, dass eine zonale Bereitstellung einen Zonenausfall nicht automatisch übersteht; Kunden müssen mehrere Zonen oder – sofern unterstützt – zonenredundante Dienste nutzen. Weitere Informationen finden Sie in der offiziellen Übersicht zu Azure-Verfügbarkeitszonen von Microsoft .
In der Praxis kann ein Cloud-Anbieter eine Zone unabhängig machen, aber die Arbeitslast eines Kunden kann immer noch eine Single-Zone-Datenbank, eine einzige regionale Steuerungsabhängigkeit oder einen Failover-Prozess aufweisen, der noch nie ausgeführt wurde.
Warum ein Cloud-Ausfall global erscheinen kann, selbst wenn die Ursache regional ist.
Der Begriff „globaler Ausfall“ beschreibt häufig die Auswirkungen auf Kunden, nicht den physischen Standort der ausgefallenen Geräte. Ein regionaler Dienst kann Authentifizierung, DNS, Metadaten, Build-Pipelines, Dashboards oder Steuerungs-APIs unterstützen, die von anderen Regionen aus genutzt werden. Anwendungen weltweit können daher ausfallen, weil sie von einem Dienst abhängen, der an einem einzigen Standort konzentriert ist.
Diese Unterscheidung ist bei der Diagnose eines Vorfalls wichtig. Ingenieure sollten zwei verschiedene Fragen stellen: Wo trat der erste Fehler auf? Und welche Abhängigkeiten ermöglichten die Ausbreitung dieses Fehlers? Die Antworten darauf unterscheiden sich häufig.
Wie man die wahrscheinliche Ursache während eines laufenden Vorfalls ermittelt
Für Betreiber ist es meist am schnellsten, Symptome zu korrelieren, anstatt jedes Produkt einzeln zu untersuchen. Fallen viele Dienste gleichzeitig aus, sollte nach einer gemeinsamen Abhängigkeit gesucht werden. Funktionieren bestehende Workloads weiterhin einwandfrei, während neue Bereitstellungen fehlschlagen, liegt der Verdacht nahe, dass ein Problem mit der Steuerungsebene, der Planung, der Kapazität oder der Bereitstellung vorliegt. Funktioniert die IP-Verbindung, aber die Dienstnamen sind nicht erreichbar, sollte das DNS überprüft werden. Steigen die Fehlerraten nach einer Wiederherstellungsankündigung, sollten mögliche Ursachen für Wiederholungsversuche, Rückstände, abgelaufene Leases, Feedbackschleifen in den Integritätsprüfungen oder unzureichende Wiederherstellungskapazität geprüft werden.
Anbieterstatussysteme können auch dabei helfen, einen Plattformvorfall von einem anwendungsspezifischen Fehler zu unterscheiden. Google Cloud veröffentlicht beispielsweise aktuelle und historische Vorfälle über sein offizielles Service Health Dashboard , während AWS Zusammenfassungen wichtiger Ereignisse über seine offiziellen Post-Event Summaries veröffentlicht .
Was Kunden tun können, um die Auswirkungen zu verringern
Keine Architektur kann Ausfallfreiheit garantieren, aber verschiedene Designentscheidungen reduzieren das Risiko. Nutzen Sie mehrere Verfügbarkeitszonen für Produktionsworkloads, sofern der Dienst dies unterstützt. Für Workloads, die einen regionalen Ausfall nicht tolerieren, sollten Sie Multi-Region-Architekturen evaluieren und die damit verbundenen Kompromisse hinsichtlich Datenkonsistenz verstehen. Beseitigen Sie versteckte Single Points of Failure, wie beispielsweise einen regionalen Identitätsdienst, einen DNS-Pfad oder eine administrative API, von der jede Wiederherstellungsmaßnahme abhängt.
Anwendungen sollten auch im Fehlerfall einen sicheren Ablauf gewährleisten. Dies kann bedeuten, zwischengespeicherte Inhalte bereitzustellen, nicht kritische Schreibvorgänge in eine Warteschlange zu stellen, Wiederholungsversuche durch exponentielles Backoff und Jitter zu begrenzen, Operationen der Steuerungsebene vom Datenverkehr zu trennen und bei Teilausfällen einen reduzierten „Nur-Lese“- oder „Kerntransaktions“-Modus beizubehalten. Wiederherstellungsverfahren sollten unter Backlog-Bedingungen getestet werden, da der Neustart einer Abhängigkeit in einer leeren Testumgebung sich deutlich von der Wiederherstellung einer Abhängigkeit unterscheidet, während Millionen von Anfragen warten.
Die wichtigste Lehre aus den weitverbreiteten Cloud-Ausfällen
Kehren wir zum Northstar-Cloud-Szenario zurück. Die Konfigurationsänderung um 10:05 Uhr mag der Auslöser sein, erklärt aber nicht alles. Der Ausfall breitet sich aus, da das Netzwerk gemeinsam genutzt wird, die Automatisierung einen Timing-Fehler aufweist, nachgelagerte Dienste vom selben Zustand abhängen, Integritätsprüfungen Kapazität verbrauchen, Wiederholungsversuche die Last erhöhen und die Wiederherstellungssysteme einen enormen Rückstand aufarbeiten müssen.
Das ist das zentrale Muster vieler schwerwiegender Cloud-Vorfälle: Der auslösende Fehler ist oft geringfügig im Vergleich zur Kette von Abhängigkeiten, die ihn verstärken. Um Cloud-Ausfallzeiten zu verstehen, müssen daher sowohl die Ursache als auch die Ausbreitung untersucht werden. Die widerstandsfähigsten Architekturen gehen davon aus, dass einzelne Komponenten ausfallen werden, und konzentrieren sich darauf, zu verhindern, dass diese Ausfälle zu systemweiten Ereignissen führen.