Prüfen Sie zunächst, ob langsame Verbindungsaufbauten einen einzelnen Raum, einen entfernten Homeserver oder alle verbundenen Räume betreffen. Nutzen Sie den Status der Verbundziele und die Protokolle von Synapse, um wiederholte Fehler zu lokalisieren, bevor Sie Timeouts ändern oder Worker hinzufügen. Da ein Verbindungsaufbau Homeserver-Grenzen überschreitet und Daten zur Verbindungsberechtigung und zum Raumstatus ausgetauscht werden, kann ein langsamer entfernter Server oder ein großer Raum einen Verbindungsaufbau verzögern, selbst wenn Ihr eigener Server einwandfrei funktioniert.
Die Matrix-Server-Server-Spezifikation beschreibt den make_joinHandshake send_joinund den an einen beitretenden Server zurückgegebenen Status. Das bedeutet, dass „Federation Lag“ nicht automatisch ein lokales Problem der Synapse-Warteschlange ist. Die folgenden Prüfungen helfen, die wahrscheinlichen Ursachen zu ermitteln.
Ist die Verzögerung auf einen Raum oder einen Heimserver beschränkt?
Vergleichen Sie einen langsamen Beitritt mit einem Beitritt zu einem anderen föderierten Raum. Fragen Sie andere Benutzer auf Ihrem Homeserver, ob sie dieselbe Verzögerung melden, und notieren Sie sich die Raum-ID oder den Alias sowie die Namen der beteiligten Remote-Server. Ist nur ein Raum langsam, könnte der Zustand des Raums oder die darin befindlichen Homeserver der Flaschenhals sein. Sind mehrere Räume mit demselben Remote-Server langsam, überprüfen Sie die Erreichbarkeit und den Wiederholungsstatus dieses Ziels. Sind Beitritte zu vielen unabhängigen Servern langsam, untersuchen Sie Ihre eigenen Ressourcen und den ausgehenden Föderationspfad.
Für den betroffenen Remote-Server fragen Sie die Synapse Federation Admin API von dem Rechner aus ab, auf dem Synapse ausgeführt wird:
curl -H "Authorization: Bearer $SYNAPSE_ADMIN_TOKEN" \
  "http://127.0.0.1:8008/_synapse/admin/v1/federation/destinations/remote.example"
Ersetzen Sie remote.example<homeservername> durch den Namen Ihres Homeservers und verwenden Sie die Client-Listener-Adresse Ihrer Bereitstellung. Ein Wert ungleich null retry_last_tsund ein positives retry_intervalErgebnis zeigen an, dass Synapse einen kürzlich fehlgeschlagenen Verbindungsversuch registriert hat und wartet, bevor es erneut versucht. Überprüfen Sie die entsprechenden Synapse-Protokolle auf die genaue Fehlerursache, z. B. DNS-, TLS-, Verbindungs- oder Remote-Antwortfehler. Synapse dokumentiert diese Federation Admin API als experimentell und Änderungen vorbehalten; konsultieren Sie die Dokumentation Ihrer Version. Halten Sie die Admin API geheim und fügen Sie deren Zugriffstoken nicht in eine öffentliche Supportanfrage ein.
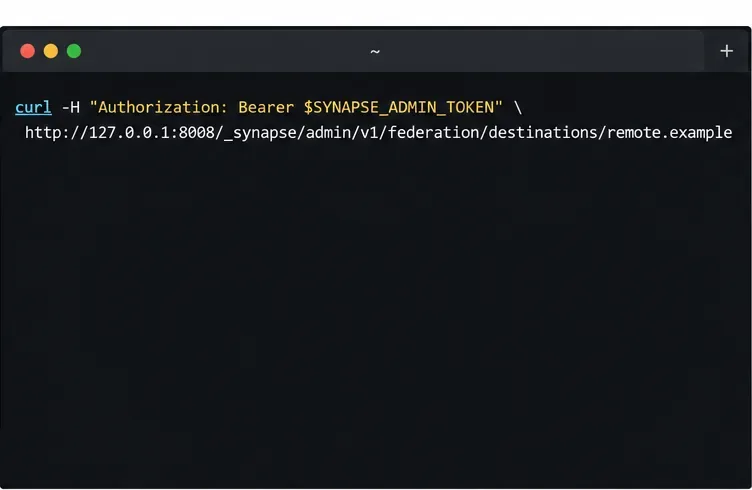
Abbildung einer lokalen, authentifizierten Zielstatusanfrage. Das Bedienfeld zeigt lediglich einen Befehl, keine Live-Antwort.
Wenn Sie vermuten, dass andere Server Ihren Heimserver nicht erreichen können, führen Sie den offiziellen Matrix Federation Tester für Ihren Servernamen aus. Dieser prüft die öffentliche Verbundermittlung und -verbindung. Er beweist jedoch nicht automatisch, dass eine ausgehende Anfrage von Ihrem Synapse-Host an einen bestimmten Peer erfolgreich ist. Vergleichen Sie daher den Bericht mit Ihren eigenen Protokollen und dem Status des Zielservers.
Zeigt Synapse eine zunehmende Verzögerung bei der Föderation?
Wenn Prometheus bereits Ihren Synapse-Metrikendpunkt abfragt, fügen Sie die betroffenen Domänen in der Konfigurationsdatei hinzu federation_metrics_domainsund homeserver.yamlladen oder starten Sie Synapse anschließend gemäß Ihrem Bereitstellungsprozess neu. Synapse kann Prometheus-Metriken für das Alter von persistenten Raumereignissen (PDUs) bereitstellen, die an die aufgelisteten Domänen gesendet und von diesen empfangen wurden, wie im Konfigurationshandbuch beschrieben .
federation_metrics_domains:
  - matrix.org
  - remote.example
Nutzen Sie die resultierende Zeitreihe, um festzustellen, ob das Alter ausgehender oder eingehender Ereignisse zunimmt. Betrachten Sie dies als einen Hinweis auf die Richtung, nicht als endgültige Aussage: Die Konfigurationsdokumentation von Synapse weist darauf hin, dass Verzögerungen sowohl vom Homeserver als auch vom Netzwerk zwischen ihnen verursacht werden können. Eine verzögerte ausgehende Datenreihe über mehrere Ziele hinweg deutet auf Ihren Sendepfad oder Ihre lokale Kapazität hin; tritt die Verzögerung nur bei einem Peer auf, sollten Sie diesen Peer und die Route zu ihm überprüfen.
Illustration eines Diagrammkonzepts zum Alter einer Föderation; die Linien stellen keine Live-Messungen von einem Synapse-Server dar.

Abbildung der Synapse-Einstellungen zur Aktivierung von PDU-Altersmetriken für ausgewählte Remote-Domänen.
Wenn viele Operationen langsam sind, überprüfen Sie CPU, Arbeitsspeicher, Datenbanklatenz und das Synapse-Dashboard zur Transaktionsdauer. Die Synapse- Grafana-Anleitung weist darauf hin, dass persist_eventsSchreibvorgänge in die Datenbank eine hohe Transaktionsdauer verursachen können; außerdem wird erklärt, dass viele Vorwärtsverbindungen den Aufwand für die Zustandsauflösung erhöhen können. Wenn diese lokalen Messwerte gleichzeitig mit Joins erhöht sind, beheben Sie den Ressourcen- oder Datenbankengpass, bevor Sie die Wiederholungsversuche der Föderation optimieren.
Würden mehr Federation-Sender-Worker helfen?
Fügen Sie die Senderkapazität nur dann hinzu, wenn die Überwachung anzeigt, dass ausgehende Daten auf mehrere Ziele verteilt sind und der aktuelle Prozess dadurch eingeschränkt ist. Die aktuelle Synapse-Worker-Dokumentation empfiehlt, für diese Rolle die Funktion synapse.app.generic_worker„mit“ zu verwenden federation_sender_instances, anstatt neue Bereitstellungen für den älteren dedizierten Sender-Worker-Typ zu erstellen.
Jedem ausgehenden Ziel wird ein Absender anhand eines Hashwerts des Remote-Servernamens zugewiesen. Mehrere Absender-Worker können den Datenverkehr auf mehrere Remote-Server verteilen, Anfragen an ein langsames Ziel werden jedoch weiterhin einem Worker zugeordnet. Das Hinzufügen von Workern behebt daher wahrscheinlich kein Problem mit einem einzelnen Peer. Die Worker-Namen in der gemeinsamen Konfiguration müssen mit den Namen der laufenden Worker übereinstimmen. Beim Ändern der Absender-Instanzliste müssen alle Federation-Absender gleichzeitig gestoppt und neu gestartet werden, damit sie dieselbe Konfiguration verwenden.
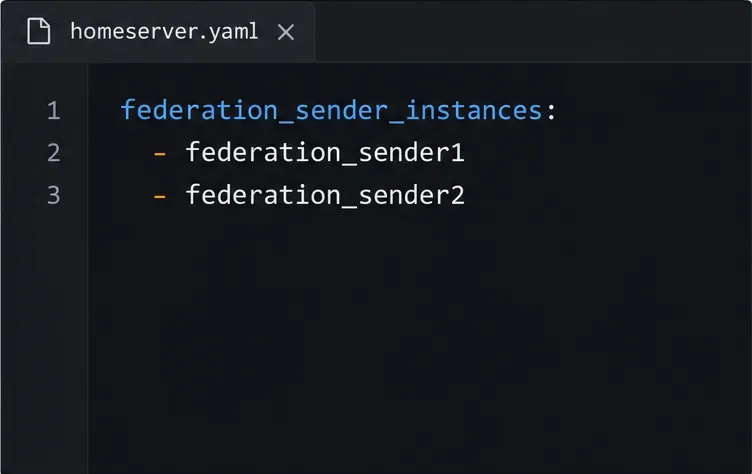
Abbildung der Liste federation_sender_instances; jeder benannte Worker muss in der Bereitstellung vorhanden sein.
Sollten Sie den Backoff zurücksetzen oder das Timeout erhöhen?
Setzen Sie den Wiederholungstimer eines Ziels erst zurück, nachdem ein vorübergehendes Verbindungsproblem behoben und bestätigt wurde, dass Synapse dieses Ziel als fehlgeschlagen markiert hat. Die Admin-API stellt einen POST /_synapse/admin/v1/federation/destinations/<destination>/reset_connectionentsprechenden Endpunkt bereit; dessen Anfrage wird im Hintergrund ausgeführt, daher bedeutet ein sofortiger HTTP-200-Statuscode nicht, dass die Föderation wiederhergestellt ist. Dieser Endpunkt ist zudem als experimentell dokumentiert.
Verwenden Sie diese Option nicht federation.client_timeoutals erste Reaktion. Das aktuelle Konfigurationshandbuch gibt einen Standardwert von 60 Sekunden vor. Ein längeres Timeout gibt einem langsamen Remote-Server mehr Zeit zum Antworten; es beschleunigt weder den Server noch das Netzwerk und kann dazu führen, dass Beitrittsanfragen länger warten müssen. Ändern Sie den Wert nur, wenn die Protokolle zeigen, dass legitime Verbundanfragen den aktuellen Wert überschreiten und Sie die Serverkapazität überprüft haben.
Woran erkennt man, dass die Reparatur funktioniert hat?
Versuchen Sie erneut, demselben Raum beizutreten, und vergleichen Sie ihn mit einem anderen Verbundraum. Stellen Sie sicher, dass das betroffene Ziel kein steigendes Wiederholungsintervall mehr anzeigt, die Protokolle erfolgreiche Verbundanfragen dokumentieren und die konfigurierten PDU-Altersmetriken nicht mehr ansteigen. Falls nur ein Raum weiterhin langsam ist, während andere Ziele einwandfrei funktionieren, teilen Sie die Raum-ID, den beteiligten Remote-Homeserver, das Zeitfenster und die geschwärzten Fehlermeldungen den Raumadministratoren oder dem Synapse-Support mit. Vermeiden Sie das Senden von Zugriffstoken oder vollständigen Autorisierungsheadern.


