Startseite
» Technologie
»
Salesforce-Ausfall 2025: Ein Rückblick auf größere Störungen
Salesforce-Ausfall 2025: Ein Rückblick auf größere Störungen
Die wichtigste Erkenntnis aus der Analyse der Salesforce-Ausfälle im Jahr 2025 ist, dass es keinen einzelnen, das Jahr prägenden „globalen Salesforce-Ausfall“ gab. Stattdessen erlebten Kunden verschiedene Störungsmuster: eine umfassende Serviceunterbrechung im Februar, Authentifizierungsfehler in mehreren Clouds im Juni, einen schwerwiegenden Vorfall auf der Heroku-Plattform aufgrund eines unbeabsichtigten Updates des Anbieters, ein Netzwerkproblem im Rechenzentrum in Indianapolis sowie spätere Vorfälle, die auf bestimmte Instanzen oder Funktionen beschränkt waren. Diese Unterscheidung ist wichtig, da die richtige Reaktion davon abhängt, was genau ausgefallen ist.
Wenn sich Benutzer nicht anmelden können, behebt ein Neuladen des Browsers das Problem nicht. Bei einer Verzögerung der öffentlichen Statusseite ist auch eine allgemeine Ausfallüberwachung möglicherweise unvollständig. Ist Salesforce verfügbar, hängt aber eine Integrationswarteschlange fest, erscheint das CRM-System selbst möglicherweise intakt, während Geschäftsprozesse weiterhin ausfallen. Die praktische Lehre für 2025 lautet daher: Mandantenspezifische Statusbenachrichtigungen, unabhängige Überwachung, getestete manuelle Verfahren und eine Wiederherstellungsprüfung für nachgelagerte Systeme sollten kombiniert werden.
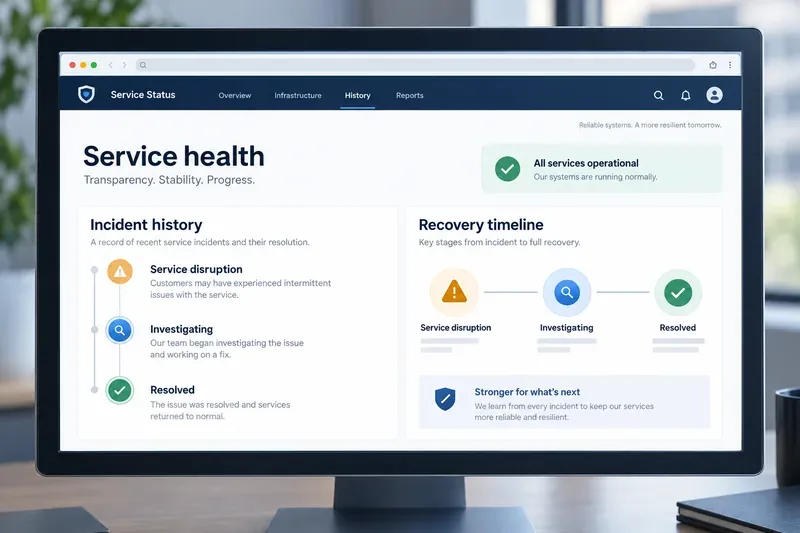
Ein generisches Service-Status-Dashboard zeigt die Phasen, die Teams bei der Rekonstruktion eines Ausfallzeitablaufs überprüfen; es handelt sich um eine konzeptionelle Darstellung, nicht um einen Live-Screenshot von Salesforce.
Welche wesentlichen Umbrüche gab es bei Salesforce im Jahr 2025?
Die folgenden Vorfälle sind für eine Retrospektive hilfreich, da sie verschiedene Fehlermodi aufzeigen. Sie stellen keine Behauptung dar, dass hier jedes Salesforce-Statusereignis im Jahr 2025 aufgeführt ist.
Datum
Störung
Was die Akten zeigen
Warum es wichtig ist
7. Februar
Serviceunterbrechung
Laut offiziellem Vorfallbericht endete die Störung um 11:21 UTC und dauerte etwa 2 Stunden und 20 Minuten.
Ein umfassendes Service-Ereignis kann den normalen Salesforce-Betrieb beeinträchtigen, selbst wenn die Ursache nicht öffentlich bekannt gegeben wird.
10. Juni
Cloudübergreifende Authentifizierungsfehler
Salesforce meldete Auswirkungen auf die Authentifizierungsdienste für Heroku, Commerce, Marketing Cloud und Salesforce-Dienste.
Abhängigkeiten bei Login und Identität können zu produktübergreifenden Ausfällen führen, ohne dass jedes Produkt denselben technischen Fehler aufweist.
10. Juni
Störungen der Heroku-Plattform
Heroku führte den Vorfall später auf ein unbeabsichtigtes Systemupdate eines Anbieters zurück, das auf der Produktionsinfrastruktur installiert worden war. Auch die Heroku-Statusseite war betroffen.
Der Kommunikationskanal kann Teil des Vorfalls werden, weshalb unabhängige Benachrichtigungswege unerlässlich sind.
18. Juni
Netzwerkstörung im Rechenzentrum von Indianapolis
Salesforce meldete, dass ein Ausfall des Kühlsystems im Rechenzentrum Indianapolis die Stacks 1 und 6 betraf.
Ereignisse im Bereich der physischen Infrastruktur können zwar einen begrenzteren Umfang haben als ein globaler Ausfall, sind aber für die betroffenen Fälle dennoch schwerwiegend.
1. November
Unterbrechung des Kerndienstes auf Instanzebene
Im offiziellen Vorfallbericht wird IND76 als betroffene Instanz identifiziert und der Vorfall als behoben vermerkt.
Instanzspezifische Prüfungen sind sinnvoller als die alleinige Verwendung allgemeiner Berichte wie „Ist Salesforce ausgefallen?“.
31. Dezember
Leistungseinbußen bei WhatsApp
Salesforce meldete Leistungseinbußen bei der WhatsApp-Messaging-Funktion auf mehreren Servern und bestätigte später die Wiederherstellung um 16:56 UTC.
Eine Funktion kann beeinträchtigt sein, während der Rest des CRM weiterhin nutzbar bleibt.
Die Vorfälle vom 10. Juni offenbaren zwei unterschiedliche Versagensebenen.
Der 10. Juni ist besonders wichtig, da „Salesforce-Ausfall“ mehrere Ereignisse beschreiben kann. Der Trust-Eintrag von Salesforce beschrieb Fehler bei der Multi-Faktor-Authentifizierung, die mehrere Clouds betrafen. Der spätere Korrekturmaßnahmenbericht von Heroku beschrieb eine Plattform-Dienststörung, die um 06:00 UTC begann und durch ein unbeabsichtigtes Systemupdate eines Anbieters auf der Produktionsinfrastruktur verursacht wurde.
Heroku bestätigte, dass seine Statusseite betroffen war. Laut dem Heroku-Update zu den Korrekturmaßnahmen führten Designmängel der Statusseite und API-Latenz zu Timeouts, wodurch die Seite scheinbar keine aktiven Vorfälle anzeigte. Heroku reagierte darauf mit Maßnahmen wie einem dauerhaften Stopp unbeaufsichtigter Betriebssystem-Upgrades von Anbietern, Image-Audits, verstärkter Überwachung, zwischengespeicherten Statusinhalten, unabhängiger Kommunikationsplanung und verbesserten Verfahren zur Reaktion auf Vorfälle.
Dies ist eine wichtige Unterscheidung für Administratoren. Eine Statusseite ist nicht der Dienst selbst, sondern wird von Kunden genutzt, um zu entscheiden, ob sie warten, einen Failover durchführen, ein Support-Ticket eröffnen oder mit ihren eigenen Benutzern kommunizieren. Wenn der Statuskanal zu viel Infrastruktur mit der betroffenen Plattform teilt, bietet er möglicherweise keine verlässliche Ansicht genau dann, wenn sie am dringendsten benötigt wird.
Was lehrte der Bericht von 2025 die Salesforce-Kunden?
1. Die Authentifizierung verdient einen eigenen Kontinuitätsplan.
Ein Team kann trotz intakter Anwendungsdaten nicht arbeiten, wenn die Anmeldung, die Multi-Faktor-Authentifizierung oder eine Verbindung fehlschlägt. Dies ist besonders wichtig für Unternehmen, die Salesforce, Heroku, Commerce und Marketing Cloud gemeinsam nutzen. Dokumentieren Sie, welche Benutzer Zugriff auf welche Systeme benötigen, benennen Sie Notfallkontakte, die Updates der Anbieter erhalten können, und definieren Sie, welche Arbeiten auch ohne erfolgreiche Anmeldung fortgesetzt werden können.
Für ein kleines Vertriebsteam kann dies eine kurzlebige, manuelle Anrufliste und ein gemeinsames Störungsprotokoll bedeuten. Für ein Contact Center oder eine Einrichtung im Gesundheitswesen sind hingegen möglicherweise ein formelles Ausfallverfahren, genehmigte, schreibgeschützte Exporte und ein getesteter Eskalationsprozess erforderlich. Der Umfang der Ausweichlösung sollte den geschäftlichen Folgen eines Systemausschlusses entsprechen.
2. Eine allgemeine Statusseite reicht nicht aus
Die Dokumentation von Salesforce erklärt, dass der Vertrauensstatus Informationen zur Verfügbarkeit und Leistung liefert, während die neueren Ansichten im „My Trust Center“ auf Mandanten und unterstützte Produkte zugeschnitten sind. Der praktische Nutzen ist einfach: Kennen Sie Ihre Instanz- oder Mandantenkennung, bevor ein Vorfall auftritt.
Salesforce bietet außerdem Anleitungen zum Abonnieren von Nachrichten und Benachrichtigungen im My Trust Center . Konfigurieren Sie Benachrichtigungen für die Personen, die handeln müssen, nicht nur für den Administrator, der die Organisation ursprünglich erstellt hat. Halten Sie einen unabhängigen Kommunikationskanal bereit, z. B. eine interne Statusseite oder eine genehmigte Nachrichtengruppe, damit Ihr Unternehmen auch dann kommunizieren kann, wenn die Statusseite eines Anbieters langsam oder nicht verfügbar ist.
3. Die Wiederherstellung umfasst mehr als nur das Anzeigen des Anmeldebildschirms.
Wenn Salesforce meldet, dass die Dienste wiederhergestellt sind, kann der Vorfall dennoch Auswirkungen auf Ihr Geschäft haben. Eine verzögerte API-Anfrage kann zweimal wiederholt werden, eine in der Warteschlange befindliche Nachricht kann verspätet eintreffen oder eine fehlgeschlagene Bereitstellung kann zu nicht synchronisierten Datensätzen führen. Überprüfen Sie nach der Wiederherstellung die wichtigsten Workflows: Authentifizierung, API-Aufrufe, geplante Jobs, Integrationswarteschlangen, E-Mail- oder Nachrichtenzustellung, Datensatzerstellung und Aktualität der Berichte.
Stellen Sie sich beispielsweise ein mittelgroßes Support-Team vor, dessen Mitarbeiter Salesforce-Fälle bearbeiten, während ein separates Handelssystem Aktualisierungen über eine Integration sendet. Wenn Salesforce um 10:00 Uhr wieder verfügbar ist, die Integrationswarteschlange aber noch fehlgeschlagene Meldungen aus dem Ausfallzeitraum enthält, sollte das Team den Vorfall nicht allein deshalb schließen, weil der Browser geladen wird. Der korrekte Test besteht darin, zu prüfen, ob neue und zuvor fehlgeschlagene Fallaktualisierungen den gesamten Workflow ohne Duplikate durchlaufen.
Welche Maßnahmen zur Aufrechterhaltung der Geschäftskontinuität passen zu Ihrer Organisation?
Geschäftslage
Praktisches Minimum
Wann mehr hinzufügen
Kleines Team; eine kurze Unterbrechung ist tolerierbar
Abonnieren Sie relevante Trust-Benachrichtigungen, notieren Sie die Instanzkennung und pflegen Sie eine kurze Checkliste für manuelle Arbeiten.
Fügen Sie Export- und Wiederherstellungstests hinzu, wenn Kundenhistorie oder Compliance-Datensätze von entscheidender Bedeutung sind.
Umsatz, Kontaktcenter oder Serviceabläufe sind den ganzen Tag von Salesforce abhängig.
Nutzen Sie unabhängiges Monitoring, ein Ausfallverfahren, Integrationswiederholungskontrollen und einen benannten Vorfallverantwortlichen.
Testen Sie die Ausfallsicherheit oder alternative Eingangskanäle während der Geschäftszeiten vor einem tatsächlichen Ausfall.
Salesforce ist mit Heroku oder mehreren Clouds verbunden.
Überwachen Sie die Statusquellen und Dokumentauthentifizierungsabhängigkeiten jedes Produkts separat.
Führen Sie gemeinsame Wiederherstellungsübungen durch, die Anmeldung, APIs, Warteschlangen und Kundenkommunikation gemeinsam testen.
Regulierte oder hochwertige Daten
Nutzen Sie ein genehmigtes Backup- und Aufbewahrungskonzept, Zugriffskontrollen, Prüfprotokolle und ein Wiederherstellungshandbuch.
Lassen Sie das Handbuch von den Abteilungen Sicherheit, Recht, Compliance und den Geschäftsinhabern prüfen.
Wie diese Rückschau im Jahr 2026 und darüber hinaus genutzt werden kann
Erstellen Sie zunächst eine einseitige Abhängigkeitsübersicht. Notieren Sie Ihre Salesforce-Instanz bzw. Ihren Mandanten, Ihren Identitätsanbieter, verbundene Clouds, wichtige Integrationen, Statusabonnements und den manuellen Prozess, der bei einem Ausfall angewendet wird. Definieren Sie anschließend für jeden wichtigen Workflow eine objektive Wiederherstellungsprüfung. „Salesforce ist wieder verfügbar“ ist zu vage; „Neue Fälle, ausgehende Nachrichten und Auftragsaktualisierungen werden ohne Duplikate verarbeitet“ ist überprüfbar.
Prüfen Sie abschließend Änderungen, die die Verfügbarkeit beeinträchtigen können: Aktualisierungen von Anbietern, Betriebssystemänderungen, Releases, Konfigurationsänderungen und Instanzmigrationen. Der Heroku-Vorfall im Juni verdeutlicht, warum unbeaufsichtigte Änderungen strenge Kontrollen erfordern und warum die Statuskommunikation selbst resilient sein muss. Das Ereignis vom 18. Juni zeigt, warum physische Kapazität und Rechenzentrumsabhängigkeiten auch in Cloud-Diensten weiterhin relevant sind. Die Funktionsbeeinträchtigung im Dezember verdeutlicht, warum Teams die tatsächlich genutzten Funktionen überwachen sollten und nicht nur die allgemeine Verfügbarkeit der Plattform.
Die geeignetste Reaktion ist daher situationsabhängig. Kleine Organisationen benötigen möglicherweise Benachrichtigungen und eine übersichtliche Checkliste. Unternehmen, die Vertrieb oder Support nicht unterbrechen können, benötigen unabhängige Überwachung, priorisierte Wiederherstellung und einen erprobten Ausfallprozess. Stark regulierte Organisationen benötigen getestete Wiederherstellungsprozesse, Nachweise und Governance. Die Ausfallstatistik von Salesforce aus dem Jahr 2025 untermauert eine schlüssige Schlussfolgerung: Resilienz basiert auf der Abhängigkeitskette des Kunden, nicht auf einem einzelnen grünen Statusindikator.
Quellen und Umfang
Diese Retrospektive verwendet Salesforce Trust-Vorfallsdatensätze und die zum Zeitpunkt der Erstellung verfügbare Salesforce- oder Heroku-Dokumentation. Vorfallseiten können nach der Behebung aktualisiert werden, und der Produktumfang von Salesforce unterscheidet sich zwischen Trust Status und My Trust Center. Wo Salesforce keine detaillierte Ursachenanalyse veröffentlicht hat, wird in diesem Artikel keine solche abgeleitet.