Startseite
» Gewusst wie
»
Ubuntu Server im Notfallmodus starten: Eine Schritt-für-Schritt-Anleitung
Ubuntu Server im Notfallmodus starten: Eine Schritt-für-Schritt-Anleitung
Beispielszenario: Casey betreut eine hypothetische Ubuntu-Server-VM, die nach einem Neustart in den Notfallmodus wechselt, kurz nachdem ein optionales Datenvolume eingebunden wurde /etc/fstab. Casey hat Konsolenzugriff, aber keine SSH-Verbindung. Die Änderung der Einbindung ist ein Hinweis, aber keine gesicherte Ursache: Der Notfallmodus kann nach mehreren fehlgeschlagenen Neustarts auftreten. Daher prüft Casey die Protokolle der aktuellen Maschine, bevor er Änderungen vornimmt. Die folgenden Terminalfenster zeigen beispielhafte Layouts und Platzhalterausgaben – keine tatsächliche Reparatur oder einen Test.
Was bedeutet der Notfallmodus?
Bei einer Ubuntu-Server-Installation mit systemd emergency.targetstartet `systemd` eine minimale Shell auf der Hauptkonsole. Diese ist eingeschränkter als `systemd` rescue.target, welches das Basissystem und die System-Mounts mit nur den wichtigsten Diensten startet. Je nachdem, wie der Notfallmodus aktiviert wurde, kann das Root-Dateisystem bereits schreibgeschützt oder beschreibbar eingebunden sein. Überprüfen Sie dies, anstatt einen der beiden Zustände anzunehmen. Weitere Informationen finden Sie in der Dokumentation zu systemd-Spezialzielen .
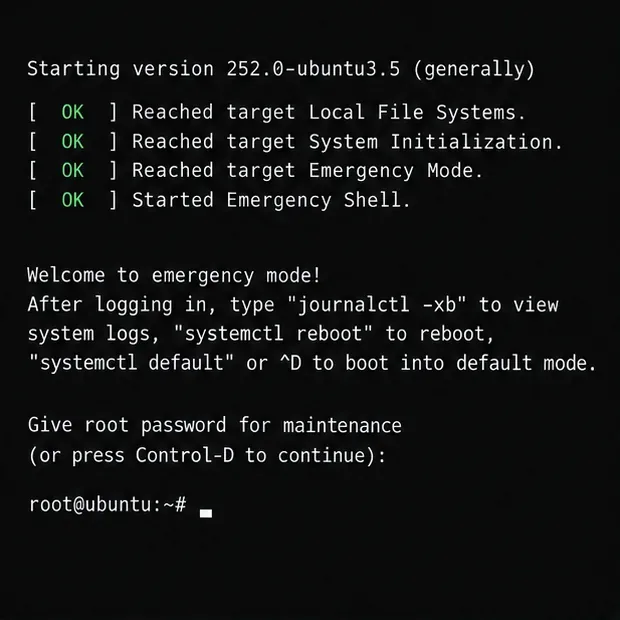
Unterscheiden Sie zunächst die Eingabeaufforderung. Eine systemd-Notfall-Shell meldet typischerweise „Willkommen im Notfallmodus!“ und fragt möglicherweise nach dem Root-Passwort für Wartungszwecke. Eine BusyBox-Eingabeaufforderung wie z. B. (initramfs)bedeutet, dass der Bootvorgang noch nicht auf das installierte Root-Dateisystem umgeschaltet hat; eine grub>andere grub rescue>Eingabeaufforderung deutet auf ein Bootloader-Problem hin. In diesen Fällen sind unterschiedliche Wiederherstellungswege erforderlich. Wenn das Root-Konto gesperrt ist oder sich der Server an einem Remote-Server befindet, verwenden Sie die serielle/VNC-Konsole oder die Rettungsumgebung Ihres Hosting-Anbieters; SSH ist in dieser Phase in der Regel nicht verfügbar. Drücken Sie nicht Strg+D, um fortzufahren, bevor Sie den gemeldeten Fehler verstanden und behoben haben.
Schritt-für-Schritt-Rettung
1. Den Konsolenzugriff aufrechterhalten und den genauen Fehler protokollieren.
Bleiben Sie in der Notfallkonsole. Notieren Sie sich den letzten fehlgeschlagenen Mount- oder Dienstnamen sowie alle Gerätepfade oder UUIDs, die über der Eingabeaufforderung angezeigt werden. Caseys kürzliche fstabÄnderung sollte überprüft werden, aber kommentieren Sie nicht jede fehlerhafte Zeile aus und führen Sie keinen Reparaturbefehl nur aufgrund des Wortes „Notfall“ aus. Wenn es sich um eine virtuelle Maschine handelt, lassen Sie die Provider-Konsole während der Reparatur und des nächsten Neustarts geöffnet.
Die Konsole identifiziert den systemd-Notfallmodus und stellt eine Wartungsshell bereit; Authentifizierung und Formulierung können je nach Konfiguration variieren.
2. Lesen Sie das aktuelle Boot-Journal und die fehlerhaften Einheiten.
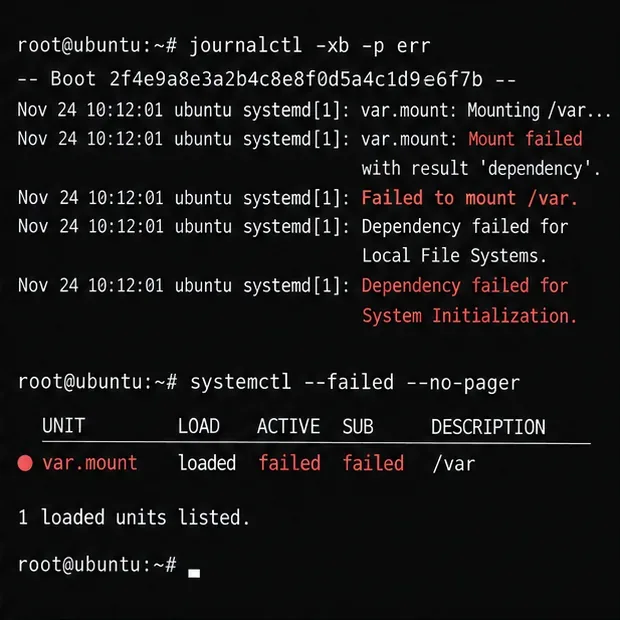
-bDie Journalabfrage wird auf diesen Bootvorgang beschränkt und -p errnach Fehlerpriorität und höher gefiltert. Es wird nach dem ersten relevanten Fehler gesucht, nicht nur nach der letzten Kette von „Abhängigkeitsfehler“-Meldungen. Wenn eine Mount-Unit fehlgeschlagen ist, werden der maskierte Unit-Name und der Zielpfad notiert; wenn ein Dienst fehlgeschlagen ist, wird ermittelt, ob dies die Ursache oder nur eine Folge eines fehlenden Mounts ist. Die Ubuntu- journalctl(1)Dokumentation beschreibt die Boot- und Unit-Filterung.
Die Ausgabe des Boot-Logs deutet auf eine fehlgeschlagene Mount-Abhängigkeit hin; der tatsächliche Unit-Name und die Meldung müssen vom Server stammen.
3. Überprüfen Sie die Root-Einbindung und den verfügbaren Speicherplatz.
Bevor Sie Dateien bearbeiten oder Reparaturen versuchen, überprüfen Sie, wie das Root-Dateisystem eingebunden ist und ob dem System die Blöcke oder Inodes ausgegangen sind:
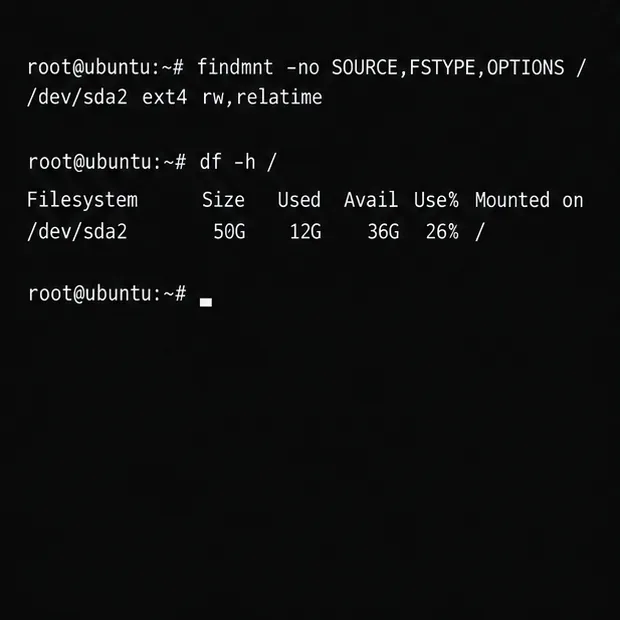
In der findmntAusgabe robedeutet „schreibgeschützt“ und rw„Lese-/Schreibzugriff“. Ein schreibgeschütztes Root-Verzeichnis kann während eines Wiederherstellungsprozesses beabsichtigt sein oder auf ein Dateisystemproblem hinweisen. Erzwingen Sie nicht sofort ein erneutes Mounten als Lese-/Schreibzugriff, wenn Kernel-Protokolle E/A- oder Dateisystemfehler melden. Ein volles Dateisystem oder eine erschöpfte Inode-Tabelle können auch zum Ausfall anderer Dienste und Mounts führen. Das Ubuntu- findmnt(8)Handbuch beschreibt, wie gemountete Dateisysteme untersucht werden.
Die Befehle zeigen an, ob das Root-Root-Modul schreibgeschützt oder beschreibbar gemountet ist und ob Festplattenblöcke verfügbar sind.
/etc/fstab4. Geräteidentifikatoren validieren und verifizieren
Da Casey kürzlich Änderungen vorgenommen hat /etc/fstab, überprüfen Sie bitte sowohl die Syntax als auch die Existenz der referenzierten Geräte:
findmnt --verify --verbose
lsblk -f
blkid
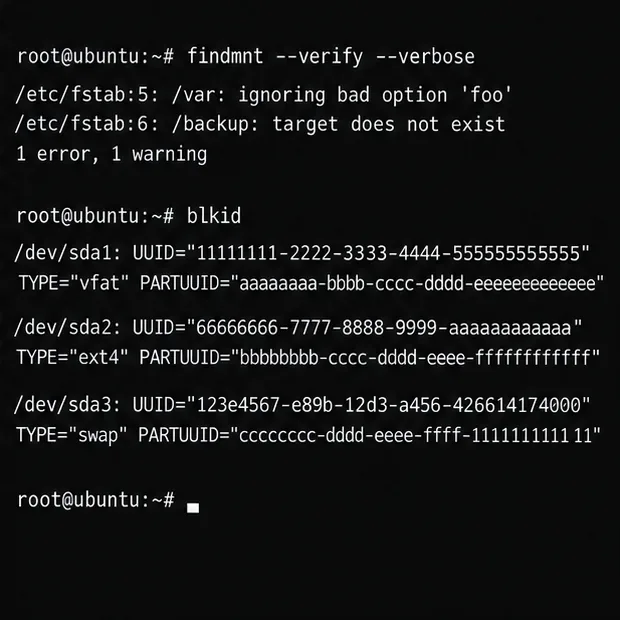
findmnt --verify --verboseÜberprüft die fstab-Einträge auf Syntax- und Nutzungsprobleme. Vergleichen Sie jeden Eintrag in der verdächtigen Zeile mit der von oder UUID=angezeigten UUID . Überprüfen Sie außerdem den Mountpunkt, den Dateisystemtyp und die Optionen. Eine kopierte UUID von einer anderen Festplatte, ein nicht angeschlossenes Gerät oder eine ungültige Option können verhindern, dass ein erforderlicher Mountvorgang abgeschlossen wird. Erraten Sie keine Partition wie z. B. ; Gerätenamen können sich zwischen Neustarts ändern.lsblk -fblkid/dev/sda1
Der Validator meldet Probleme mit der fstab-Datei, während blkid Geräte-UUIDs auflistet, die mit dem verdächtigen Eintrag verglichen werden sollen.
5. Beheben Sie nur das bestätigte Montageproblem.
Wenn das Root-Dateisystem beschreibbar ist und die fstab-Prüfung eine fehlerhafte Zeile identifiziert, erstellen Sie vor der Bearbeitung eine Sicherungskopie:
cp -a /etc/fstab /etc/fstab.before-rescue
nano /etc/fstab
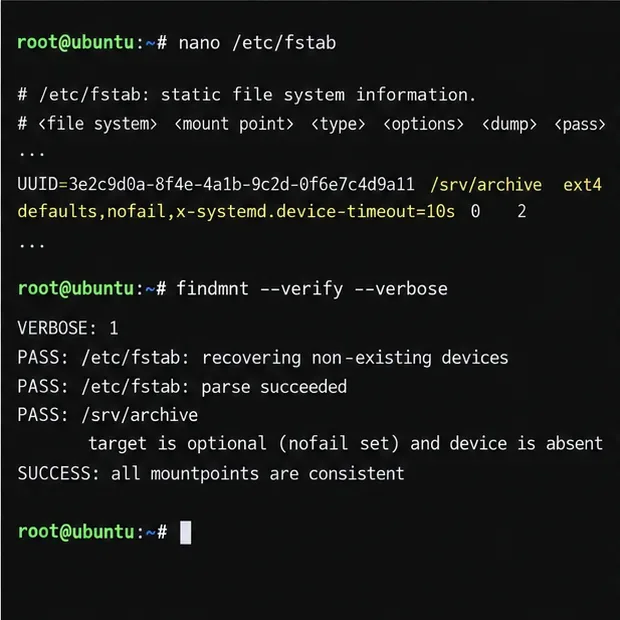
Korrigieren Sie die UUID oder ein anderes Feld erst, nachdem Sie das gewünschte Gerät bestätigt haben. Wenn die Einbindung tatsächlich optional ist und der Server auch ohne dieses Volume starten soll, kann nofailbeispielsweise eine systemd-kompatible fstab-Zeile und eine endliche Geräte-Wartezeit verwendet werden:
Ersetzen Sie den Platzhalter durch die tatsächliche UUID und verwenden Sie den korrekten Dateisystemtyp. Fügen Sie keine Einträge nofailzu root, boot oder anderen Dateisystemen hinzu, die für den korrekten Betrieb des Systems oder seiner Anwendungen erforderlich sind. Mit dieser Option nofailwird der Systemstart auch dann fortgesetzt, wenn das Mounten fehlschlägt. Abhängige Dienste müssen daher möglicherweise weiterhin überprüft werden. Die Dokumentation dieser fstab-Optionen finden Sie im Handbuch zur Ubuntu -Systemd-Mount-Unit .
Nach der Bearbeitung erneut überprüfen, bevor Sie die Montage versuchen:
findmnt --verify --verbose
systemctl daemon-reload
mount /srv/archive
Verwenden Sie im letzten Befehl den tatsächlichen Mountpunkt. Falls der Fehler weiterhin besteht, lesen Sie die neue Fehlermeldung und prüfen Sie, ob die Festplatte angeschlossen und fehlerfrei ist. Wenn das Root-Dateisystem schreibgeschützt ist, erzwingen Sie keine Änderungen ohne vorherige Prüfung. Verwenden Sie stattdessen eine Wiederherstellungsumgebung Ihres Anbieters oder ein bootfähiges Ubuntu-Medium, um das installierte System sicher zu untersuchen und zu bearbeiten.
Das Beispiel kennzeichnet lediglich eine nicht essentielle Archiv-Einbindung als optional und überprüft anschließend die fstab.
6. Untersuchen Sie einen fehlgeschlagenen Dienst nur dann, wenn das Protokoll darauf hinweist.
Der Notfallmodus bedeutet nicht, dass jeder ausgefallene Dienst zum Bootstopp geführt hat. Wenn die entsprechende Fehlermeldung einen Dienst nennt, überprüfen Sie dieses Gerät und seine Protokolle, anstatt es zu maskieren oder zu deaktivieren.
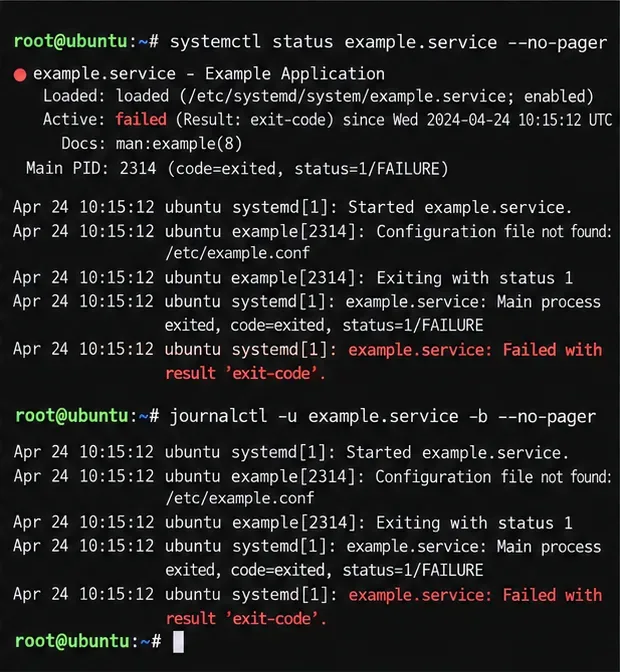
systemctl status example.service --no-pager
journalctl -u example.service -b --no-pager
Ersetzen Sie dies example.servicedurch den exakten Gerätenamen. Prüfen Sie, ob die Konfigurationsdatei, die ausführbare Datei, die Anmeldeinformationen oder die erforderliche Einbindung fehlen. Falls der Fehler auf das fehlende Datenvolume von Casey zurückzuführen ist, beheben Sie zuerst die fehlende Einbindung und prüfen Sie den Dienst anschließend erneut. Das Deaktivieren eines wichtigen Dienstes kann das Symptom zwar verschleiern, den Server aber unbrauchbar machen.
Der Servicestatus und das Protokoll helfen dabei, eine Grundursache von Fehlern zu unterscheiden, die durch eine andere fehlende Abhängigkeit verursacht werden.
7. Dateisystemfehler als Offline-Reparaturaufgabe behandeln
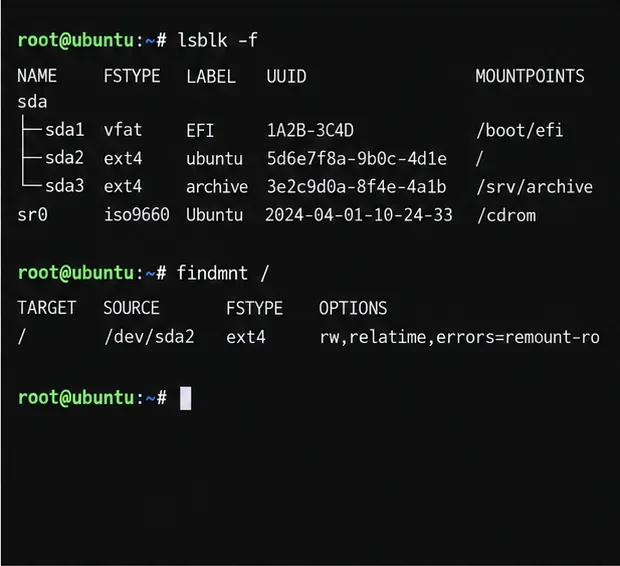
Meldet das Kernel-Journal Dateisystembeschädigungen oder Speicher-E/A-Fehler, sollten Sie nach Möglichkeit keine weiteren Schreibvorgänge durchführen und vor der Reparatur ein Backup oder einen Provider-Snapshot erstellen. Bestätigen Sie das genaue Gerät und Dateisystem mit dem lsblk -fentsprechenden Tool. Bei einem Root-Dateisystem starten Sie das Rettungssystem des Providers oder ein Ubuntu-Wiederherstellungs-/Live-Medium, stellen Sie sicher, dass die Zielpartition ausgehängt ist, und verwenden Sie das für dieses Dateisystem geeignete Prüfprogramm. Für ext2/3/4 ist dies das Tool e2fsck; für XFS, Btrfs und andere Formate gelten andere Vorgehensweisen.
Führen Sie niemals fsckeinen Befehl e2fsckauf einem eingebundenen Dateisystem aus, auch nicht auf einem eingebundenen, schreibgeschützten Root-Dateisystem. Das Ubuntu- e2fsck(8)Handbuch warnt davor, dass die Überprüfung eines eingebundenen Dateisystems generell unsicher ist und die Ergebnisse ungültig sind. Wenn die Festplatte wiederholt E/A-Fehler meldet, priorisieren Sie die Datenwiederherstellung oder die Kontaktaufnahme mit dem Speicheranbieter gegenüber wiederholten Reparaturversuchen.
Die Datenträgerauflistung hilft dabei, die richtige Partition zu identifizieren; das Root-Dateisystem bleibt gemountet und ist daher nicht bereit für fsck.
8. Kehren Sie zum normalen Systemstart zurück und überprüfen Sie das Ergebnis.
Sobald die bestätigte Ursache behoben ist, starten Sie das System über die Konsole neu:
systemctl reboot
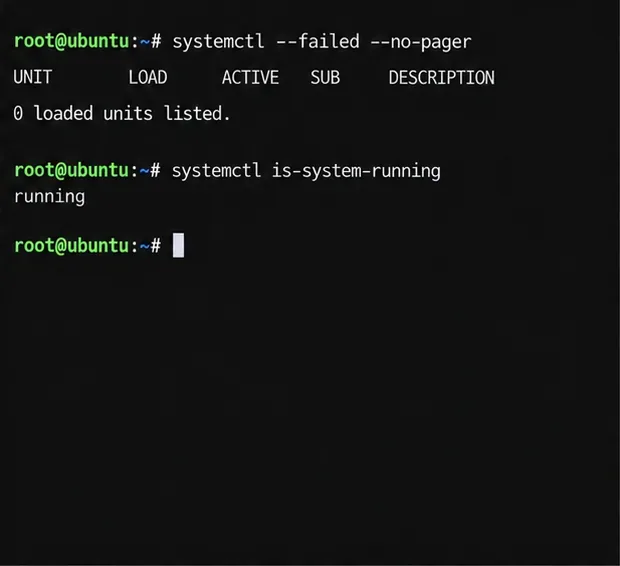
Nach dem Start von Ubuntu sollten Sie das konfigurierte Standardziel, den aktuellen Systemstatus, fehlgeschlagene Einheiten und den neuen Bootvorgang überprüfen:
Wenn Sie absichtlich im aktuellen Bootvorgang fortfahren, systemctl defaultweist dies systemd an, das konfigurierte Standardziel zu starten. Verwenden Sie dies erst, nachdem der blockierende Fehler behoben wurde; es repariert keine ungültigen Mounts oder beschädigten Dateisysteme. systemctl get-defaultzeigt das konfigurierte Standardziel an und systemctl is-system-runningmeldet, ob systemd den aktuellen Zustand als aktiv, beeinträchtigt oder anderweitig einstuft. Eine erfolgreiche Wiederherstellung bedeutet, dass die erwarteten Dateisysteme gemountet sind, die erforderlichen Dienste aktiv sind und der gleiche Notfallzustand nach einem Neustart nicht erneut auftritt.
Das Terminal zeigt die Systemctl-Prüfungen auf fehlgeschlagene Einheiten an und prüft, ob das System nach dem Neustart noch läuft.
Wenn die Eingabeaufforderung (initramfs)stattdessen lautet
Wenden Sie die systemd emergency-shell-Schritte nicht unüberlegt in BusyBox initramfs an. Die initramfs-Phase versucht, das eigentliche Root-Dateisystem zu finden und einzubinden, bevor die Kontrolle an das installierte System übergeben wird. Notieren Sie den genauen Fehler, prüfen Sie, ob das erwartete Gerät in `/ etc/initramfs` /devund `/etc/root` aufgeführt ist /dev/disk/by-uuid, und vergleichen Sie den root=Wert der Boot-Befehlszeile mit der tatsächlichen Root-UUID. Falls die Festplatte oder das verschlüsselte/LVM-Volume fehlt, verwenden Sie die Speicher- und Rettungstools des Anbieters zur Untersuchung. Das Neuerstellen von initramfs oder das Ändern von GRUB-Parametern ohne Identifizierung des fehlenden Geräts kann die Wiederherstellung nach dem Booten erschweren.
Für Caseys hypothetische VM besteht das sinnvolle Ergebnis in der Verifizierung der Ursache und einer präzisen Korrektur: Das erwartete optionale Volume wird wiederhergestellt, seine bestätigte Kennung korrigiert oder es wird nur dann als optional konfiguriert, wenn die Arbeitslast dies tatsächlich zulässt. Anschließend wird der nächste Systemstart über die Konsole überprüft, bevor die Wiederherstellungssitzung geschlossen wird.