Startseite
» Gewusst wie
»
SLES Thin Pool hat keinen Speicherplatz mehr: LVM sicher erweitern und Schreibvorgänge wiederherstellen
SLES Thin Pool hat keinen Speicherplatz mehr: LVM sicher erweitern und Schreibvorgänge wiederherstellen
Wenn ein Thin-Provisioning-Volume auf einem SUSE Linux Enterprise Server die Meldung „Kein Speicherplatz mehr verfügbar“ meldet, überprüfen Sie zunächst den Thin-Pool Data%. Meta%Ist der Datenbereich voll und die Volume-Gruppe verfügt über freie Extents, erweitern Sie den Thin-Pool um lvextenddie virtuelle Größe des Thin-Volumes. Anders verhält es sich mit einem vollständig vollen Metadatenbereich: Hier kann eine Offline-Reparatur erforderlich sein, bevor normale Schreibvorgänge wieder möglich sind.
1. Prüfen Sie, ob der Datenspeicher oder die Metadaten erschöpft sind.
Führen Sie auf dem Host, dem der aktive Thin Pool gehört, folgenden Befehl aus und ersetzen Sie dabei „ vgdataVolume-Gruppenname“ durch Ihren Volume-Gruppennamen:
sudo lvs -a -o lv_name,lv_size,segtype,data_percent,metadata_percent,pool_lv vgdata
Suchen Sie die Zeile mit thin-pooldem Punkt darunter SegType. Data%misst die zugewiesenen Datenblöcke; Meta%misst die Mapping-Metadaten des Pools. Dies sind separate Kapazitätsgrenzen. Data%Liegt nahe bei 100, aber Meta%deutlich darunter, sind zusätzliche Datenerweiterungen die direkteste Lösung. Meta%Liegt bei 100, befolgen Sie die Wiederherstellungsmaßnahmen in Abschnitt 4.
Beispielhafte Terminalansicht: Der Datenpool ist fast voll, während die Metadatennutzung deutlich geringer ist. Die Werte zeigen die zu prüfenden Felder an und stellen kein Live-Diagnoseergebnis dar.
Nehmen wir als hypothetisches Beispiel an, vgdata/pool0der Pool sei 100 GiB groß, davon 98,12 % Datennutzung und 40,26 % Metadatennutzung. Der Pool ist unmittelbar gefährdet, selbst wenn df -hausreichend Speicherplatz in einem eingebundenen Thin Volume gemeldet wird. Die virtuelle Größe eines Thin Volumes kann die physische Kapazität des Pools überschreiten, wie die Dokumentation von SUSE Expert Partitioner erläutert.
Prüfen Sie auch die kürzlich aufgetretenen Fehler:
Ein leeres grep-Ergebnis sollte nicht als Beweis dafür interpretiert werden, dass keine Schreibfehler aufgetreten sind. Überprüfen Sie auch die Anwendungsprotokolle, insbesondere wenn eine Datenbank oder virtuelle Maschine Schreibvorgänge durchführte, als der Pool voll war.
2. Bestätigen Sie, dass die Volumengruppe über freie physikalische Ausdehnungen verfügt.
Bevor Sie die Poolgröße ändern, prüfen Sie, ob die Volumengruppe die Erweiterung finanzieren kann:
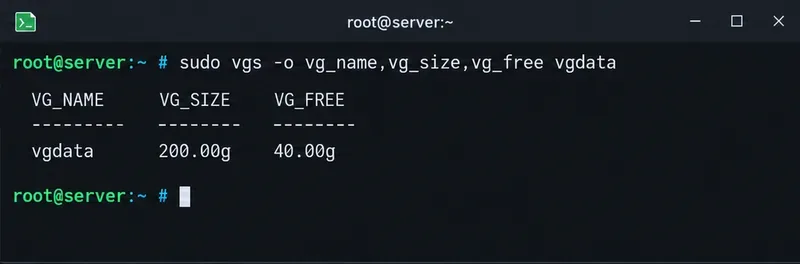
sudo vgs -o vg_name,vg_size,vg_free vgdata
Beispiel für eine Volume-Gruppenprüfung: VG_FREE gibt an, ob physische Extents verfügbar sind, um pool0 zu vergrößern, ohne ein weiteres Gerät hinzuzufügen.
Im hypothetischen Beispiel verfügt die 200-GiB-Volume-Gruppe über 40 GiB freien Speicherplatz. Eine Poolerweiterung um 20 GiB ist daher prinzipiell möglich, vorbehaltlich der Zuweisungsbeschränkungen und des verfügbaren Platzes für zukünftiges Metadatenwachstum. Es empfiehlt sich, etwas Speicherplatz in der Volume Group als Reserve zu halten, anstatt den gesamten freien Speicherplatz dem Pool zuzuweisen.
Ist VG_FREEder Wert Null, lvextendkann keine physische Kapazität erzeugt werden. Fügen Sie der Volume Group ein korrekt identifiziertes, vorbereitetes physisches Volume hinzu, vergrößern Sie den zugrunde liegenden Speicher und dessen LVM-PV gegebenenfalls oder geben Sie Blöcke frei, bevor Sie es erneut versuchen. SUSE dokumentiert das Hinzufügen physischer Volumes beim Ändern der Größe einer Volume Group . Führen Sie den Vorgang niemals pvcreateauf einer nicht verifizierten Festplatte aus: Dies kann vorhandene Speichermetadaten zerstören.
3. Erweitern Sie den dünnen Pool anstatt des dünnen Volumens.
Wenn Data%der limitierende Faktor ist, die Metadaten nicht erschöpft sind und ausreichend VG-Bereiche frei sind, erweitern Sie den Pool selbst:
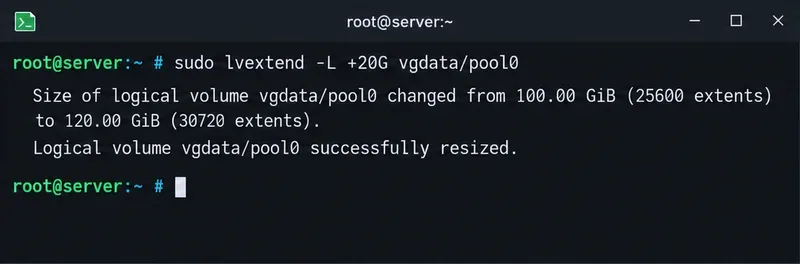
sudo lvextend -L +20G vgdata/pool0
Beispiel für eine Thin-Pool-Erweiterung: Der Befehl zielt auf vgdata/pool0 ab, nicht auf das darin enthaltene Thin-Logical-Volume. Die angezeigte Antwort dient der Veranschaulichung.
Die +20GSyntax fügt der aktuellen Poolgröße 20 GiB hinzu; sie legt die endgültige Größe nicht auf 20 GiB fest. In diesem Beispiel wächst der zugrunde liegende Pool von 100 GiB auf 120 GiB. Bei unveränderten zugewiesenen Daten würden die belegten 98,12 GiB etwa 81,8 % des vergrößerten Pools ausmachen. Der tatsächliche Prozentsatz kann abweichen, wenn während des Vorgangs weiterhin Schreibvorgänge stattfinden.
Nicht ersetzen .lvextend -L +20G vgdata/thin1 Die Vergrößerung des virtuellen Adressraums eines Thin Volumes erhöht nicht zwangsläufig die physische Datenkapazität seines Pools. Da dieser Befehl den zugrunde liegenden Pool und nicht das virtuelle Blockgerät des Dateisystems erweitert, ist für diesen Vorgang normalerweise keine Dateisystem-Größenänderung erforderlich. Das maßgebliche LVM-Handbuch zur Thin-Provisionierung beschreibt den Mechanismus zur Erweiterung des Thin-Pools und seine Grenzen.
Wenn Sie den Pool nicht sofort erweitern können
Wenn Dateien bereits aus einem schlanken Dateisystem gelöscht wurden und das Verwerfen von Blöcken vom gesamten Stack unterstützt wird, sollten Sie die Rückgewinnung verworfener Blöcke in Betracht ziehen:
sudo fstrim -v /srv/data
Verwenden Sie den tatsächlichen Mountpunkt eines Thin Volumes, nicht den des Thin-Pool-Geräts. Ein erfolgreicher Trim-Vorgang kann die Speicherkapazität reduzieren Data%, aber das alleinige Löschen von Dateien gibt in der Regel keine Blöcke an den Pool zurück. Thin Snapshots können gemeinsam genutzte Blöcke beibehalten, und ein Pool, der so konfiguriert ist, dass er verworfene Dateien ignoriert, profitiert nicht davon. Behandeln Sie Trim nicht als zuverlässigen Notfallersatz für physische Kapazität, insbesondere wenn Schreibvorgänge fehlschlagen. Entfernen Sie alte Snapshots erst, nachdem Sie deren Eigentümerschaft, Abhängigkeiten und Aufbewahrungsanforderungen geprüft haben; das Löschen von Snapshots ist unumkehrbar.
4. Behandeln Sie einen vollständigen Metadatenbereich als Wiederherstellungszustand
Wenn Meta%der Wert 100 % erreicht hat, stoppen Sie die Schreibvorgänge der Anwendung und planen Sie eine kontrollierte Ausfallzeit. LVM warnt davor, dass eine Erschöpfung der Metadaten zu Inkonsistenzen zwischen den Metadaten des Thin-Pools und den Dateisystemen führen kann. Eine bloße Erhöhung der Poolgröße, das Wiederholen von Schreibvorgängen oder das Erzwingen der Aktivierung beheben dieses Risiko nicht.
Die dokumentierte Wiederherstellungssequenz sieht wie folgt aus: Deaktivierung des betroffenen Pools im Offline-Modus, Reparatur seiner Thin-Metadaten lvconvert --repair VG/ThinPool, Erweiterung der Metadatenkapazität lvextend --poolmetadatasizeund anschließende Überprüfung jedes betroffenen Dateisystems mit dem entsprechenden Offline-Tool. Beispielsweise könnte ein Pool, dessen Metadaten-LV kleiner als 2 GiB ist, ein überprüftes Ziel wie das folgende erfordern:
sudo lvextend --poolmetadatasize 2G vgdata/pool0
Dieser Befehl sollte nicht ohne Weiteres auf einem aktiven, beschädigten Pool ausgeführt werden. Die angegebene Größe dient lediglich als Beispiel und ist keine allgemeingültige Anforderung. Prüfen Sie zunächst die aktuelle Metadatengröße, die verfügbaren Extents, die korrekte Deaktivierung, die Wiederherstellungsmedien und die Backups. Die Durchführung lvconvert --repairmuss unter Berücksichtigung von Ausfallzeiten und Expertise im Bereich der Datenwiederherstellung geplant werden; das LVM-Handbuch weist darauf hin, dass der Vorgang fehlschlagen und Datenverlust möglich ist. Bewahren Sie das alte Metadaten-LV auf, bis der Pool und die Dateisysteme überprüft wurden. Ein LVM-Konfigurations-Backup vgcfgbackupsichert keine Thin-Pool-Metadaten. Wenden Sie sich bei geschäftskritischen Daten an den SUSE-Support oder Ihr Storage-Recovery-Team, bevor Sie einen Reparaturversuch unternehmen.
5. Automatische Erweiterung aktivieren und anschließend die Schreibvorgänge überprüfen.
Sobald das System stabil ist, konfigurieren Sie eine proaktive Wachstumsrichtlinie im activationAbschnitt /etc/lvm/lvm.conf. Dieses Beispiel beginnt die Erweiterung bei 70 % Auslastung und fordert ein Wachstum von 20 % an; passen Sie diese Werte für die Schreibrate und die verfügbare VG-Kapazität an:
Stellen Sie sicher, dass die Einstellungen auf den richtigen Konfigurationsbereich angewendet werden und der Pool überwacht wird:
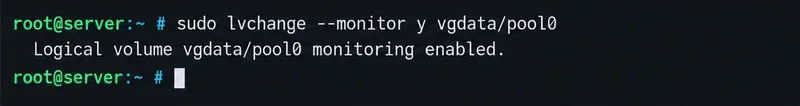
sudo lvchange --monitor y vgdata/pool0
Beispiel für einen Überwachungsbefehl: Durch die Aktivierung der LVM-Ereignisüberwachung können automatische Poolwachstumsrichtlinien greifen, wenn noch ausreichend freie Extents vorhanden sind.
Automatisches Thin-Pool-Wachstum hängt von der LVM-Ereignisüberwachung dmeventdund ausreichend freiem Speicherplatz ab. Prüfen Sie den Überwachungsdienst Ihrer SLES-Installation – beispielsweise, systemctl status lvm2-monitorwo sich die entsprechende Unit befindet – und analysieren Sie dessen Protokolle. Ein Schwellenwert bietet keinen Schutz, wenn die Schreibvorgänge die Erweiterung überschreiten oder die Volume Group bereits voll ist. Weitere Informationen finden Sie im LVM-Handbuch unter „Automatische Erweiterung“ und „lvchange-Überwachungsoptionen“ .
Überprüfen Sie, ob die Reparatur funktioniert hat.
Lesen Sie sich sowohl die Poolauslastung als auch die verbleibende Kapazität des VG erneut durch:
Data%Der Speicherverbrauch sollte nach der Erweiterung des Datenpools gesunken sein, Meta%darf die Speichergrenze nicht überschreiten und der Pool sollte ohne neue E/A-Fehler aktiv sein. Überprüfen Sie den Dateisystemstatus und die Anwendungsprotokolle und führen Sie anschließend einen kleinen, anwendungsspezifischen Schreib- und Lesetest durch, bevor Sie angehaltene Workloads freigeben. Falls die Fehler nach Verfügbarkeit von Speicherplatz weiterhin bestehen, halten Sie den betroffenen Workload offline, bis die Integrität des Dateisystems und der Anwendung überprüft wurde; zusätzliche Kapazität kann bereits fehlgeschlagene oder verlorene Schreibvorgänge nicht rückgängig machen.