Startseite
» Heute
»
Opus 5.5: Was das neue KI-Modell kann und wie es sich von ChatGPT und Claude unterscheidet
Opus 5.5: Was das neue KI-Modell kann und wie es sich von ChatGPT und Claude unterscheidet
Opus 5.5 im Vergleich: Was das neue KI-Modell kann – und was „ChatGPT gegen Claude“ wirklich bedeutet
Stand: 23. September 2026. Wer ein neues KI-Modell ausprobieren möchte, steht oft vor einer praktischen Frage: Kann es lange Unterlagen verstehen, verlässlich recherchieren und anschließend mit Zahlen oder Code arbeiten – oder klingt die Antwort nur überzeugend? Anthropic hat Claude Opus 5.5 am 22. September 2026 vorgestellt. Einen unabhängigen direkten Praxistest dieses Modells enthält dieser Artikel nicht. Herstellerangaben und Benchmarks werden deshalb als solche gekennzeichnet.
Als roter Faden dient ein ausdrücklich hypothetisches Beispiel: Ein fiktives kleines Handelsunternehmen möchte zwei umfangreiche Lieferantenverträge und eine Tabelle mit Verkaufszahlen prüfen lassen. Es bittet ein KI-System, die wichtigsten Unterschiede zusammenzufassen und einen kleinen Prüfplan für die Umsatzzahlen vorzuschlagen. Dieser Fall ist erfunden; er ist weder ein Testbericht noch ein Beleg dafür, dass ein Modell die Aufgabe fehlerfrei lösen würde.
Zuerst die Begriffe sortieren: Modell oder KI-Dienst?
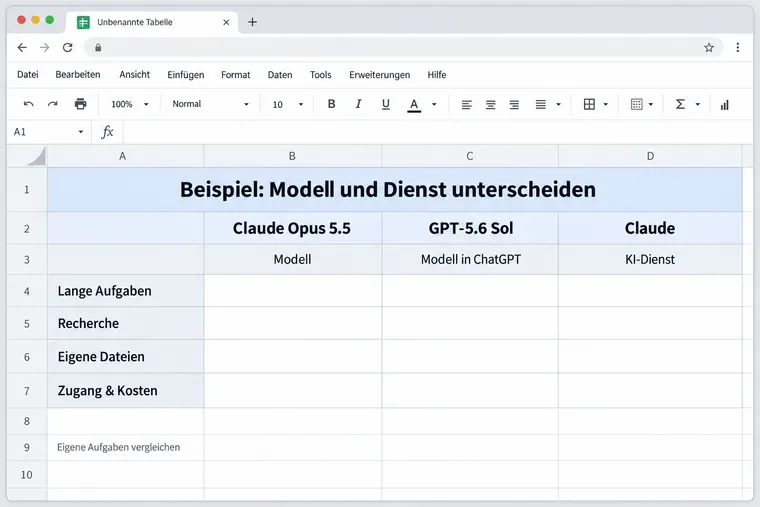
„Opus 5.5 gegen ChatGPT und Claude“ klingt wie ein Vergleich dreier gleichartiger Produkte. Genau genommen werden hier unterschiedliche Ebenen vermischt. Claude Opus 5.5 ist ein Modell von Anthropic. Claude ist zugleich der Name des Chat-Dienstes, über den Menschen mit Modellen und verfügbaren Werkzeugen arbeiten. ChatGPT ist der KI-Dienst von OpenAI; darin stehen je nach Tarif, Konto und Rollout verschiedene Modelle zur Wahl, darunter laut OpenAI GPT-5.6 Sol.
Für das fiktive Handelsunternehmen bedeutet das: Es könnte nicht nur zwei Modellnamen vergleichen, sondern auch zwei Arbeitsumgebungen. Eine Chat-Oberfläche kann Dateiupload, Websuche, Kontoeinstellungen und Exportfunktionen bündeln. Die Verfügbarkeit dieser Werkzeuge folgt nicht automatisch aus den Fähigkeiten des zugrunde liegenden Modells. Ebenso können Modelle über eine Programmierschnittstelle (API) angeboten werden, ohne dass API-Nutzung dasselbe wie ein Chat-Abonnement ist.
Begriff
Was er bezeichnet
Worauf beim Vergleich zu achten ist
Claude Opus 5.5
Anthropics Modell der Opus-Reihe
Modellversion, Kontext, Werkzeuge, Tarif und Nutzungskanal
GPT-5.6 Sol
Ein von OpenAI genanntes Modell innerhalb von ChatGPT
Rollout und Verfügbarkeit laut Konto oder verwaltetem Arbeitsbereich
Claude
Anthropics Chat-Dienst mit auswählbaren Modellen und Funktionen
App-Funktionen, Tarif, Arbeitsbereich und verfügbare Modelle
ChatGPT
OpenAIs Chat-Dienst mit Modellen und integrierten Werkzeugen
Plan, Modellwahl, Rollout und aktivierte Funktionen
Was Anthropic zu Opus 5.5 veröffentlicht hat
In der Ankündigung vom 22. September positioniert Anthropic Opus 5.5 für agentisches Programmieren, Computerbedienung und anspruchsvolle Wissensarbeit. Mit „agentisch“ sind Aufgaben gemeint, bei denen ein Modell über mehrere Schritte hinweg Ziele verfolgt und Werkzeuge einsetzen kann. Die Formulierung beschreibt eine Ausrichtung, keine Garantie, dass das Modell auf jedem Rechner oder bei jeder Aufgabe autonom und zuverlässig arbeitet. Die Einzelheiten stehen in Anthropics offizieller Vorstellung von Claude Opus 5.5.
Anthropic nennt für den API-Zugang einen Preis von 4 US-Dollar pro Million Eingabetokens und 20 US-Dollar pro Million Ausgabetokens. Der Anbieter erklärt außerdem, typische Aufgaben kosteten 40 Prozent weniger als bei Opus 5, und die Ausgabe sei in den verglichenen Abläufen schneller. Das sind Angaben des Herstellers. Sie sagen nicht voraus, was eine konkrete Anfrage kostet: Eingabe- und Ausgabemenge, verwendete Werkzeuge und Arbeitsweise beeinflussen den Verbrauch. API-Preise lassen sich auch nicht fair mit dem Monatspreis eines Chat-Abos gleichsetzen. Vor dem Einsatz sollte man die aktuelle Preis- und Tarifseite prüfen, besonders bei Cloud-Anbietern oder Geschäftskonten.
In den Anthropic-API-Hinweisen wird Opus 5.5 mit der Modellkennung claude-opus-5-5, einem Kontextfenster von einer Million Tokens und einer maximalen Ausgabe von 128.000 Tokens aufgeführt. Ein großes Kontextfenster kann bei der hypothetischen Vertragsprüfung helfen, weil mehr Ausgangsmaterial in einem Auftrag berücksichtigt werden kann. Es ist aber kein Gütesiegel: Relevante Klauseln können übersehen oder falsch zusammengefasst werden. Außerdem nennt Anthropics Hilfeseite für bezahlte Claude-Pläne ebenfalls eine Million Tokens für Opus 5.5; daraus sollte man keine Verfügbarkeit im kostenlosen Angebot ableiten. Die Angaben sind in den offiziellen Claude-API-Versionshinweisen und den Hinweisen zum Kontextfenster bezahlter Claude-Pläne dokumentiert.
Wie unterscheidet sich Opus 5.5 von GPT-5.6 Sol und den Diensten?
OpenAI beschreibt GPT-5.6 Sol als Modell für komplexe Aufgaben unter anderem in Programmierung, Recherche, Wissenschaft, Cybersecurity, Computerbedienung und Design. Laut OpenAI begann die Verteilung in ChatGPT am 9. Juli 2026 für berechtigte kostenpflichtige Pläne; kostenlose und ausgeloggte Nutzung ist davon nicht automatisch umfasst. Verfügbarkeit kann von Plan und verwalteten Arbeitsbereichen abhängen. Den jeweils aktuellen Stand nennt OpenAIs offizielle Seite zu ChatGPT-Modellveröffentlichungen.
Damit gibt es eine thematische Überschneidung: Beide Anbieter sprechen über komplexe Arbeit, Programmieren und Computerbedienung. Aus den Funktionsbeschreibungen allein lässt sich aber kein Sieger ableiten. Im Beispiel mit den Lieferantenverträgen wären wichtige Fragen: Kann das ausgewählte Konto die Dateien annehmen? Zeigt das System nachvollziehbar, auf welche Stellen es sich stützt? Werden Zahlen aus der Tabelle korrekt übernommen? Kann der Nutzer jeden Vorschlag prüfen, bevor er in einen Geschäftsprozess einfließt?
Anthropic veröffentlicht auch Benchmark-Ergebnisse, in denen Opus 5.5 bei bestimmten Aufgaben vor anderen Modellen liegt. Solche Tabellen sind ein nützlicher Hinweis darauf, welche Aufgaben der Anbieter untersucht hat. Sie sind jedoch kein neutraler Direktvergleich für den eigenen Betrieb: Testbedingungen, Modellkonfigurationen, Werkzeugzugriff und Auswertung können voneinander abweichen. Anthropic weist selbst darauf hin, dass kleine Benchmark-Abstände nicht verlässlich in Unterschiede im Alltag übersetzt werden können. Für die fiktive Firma wäre ein hoher Benchmarkwert deshalb kein Ersatz für eine Prüfung ihrer Dokumente und Rechenregeln.
Schematische Vergleichstabelle mit Opus 5.5, GPT-5.6 Sol und Claude. Die Kriterien sind aufgeführt, aber es werden keine Testergebnisse oder Ranglisten gezeigt.
So lässt sich das hypothetische Beispiel fair auf die eigene Arbeit übertragen
Wer Modelle ernsthaft vergleichen möchte, sollte nicht mit einer offenen Frage wie „Welches ist das beste?“ beginnen. Besser ist eine kleine, wiederholbare Aufgabe mit einem klaren Maßstab. Für das fiktive Handelsunternehmen könnte die Prüfung so aussehen:
Aufgabe eingrenzen. Vor dem Hochladen wird festgelegt, was die KI liefern soll: eine Liste von Vertragsunterschieden mit Seitenangaben und eine Beschreibung der nötigen Umsatzprüfungen. Eine Entscheidung über Vertragsannahme oder Zahlung bleibt bei einer zuständigen Person.
Material bereinigen. Namen, Kontaktdaten, Kontonummern und vertrauliche Angaben werden entfernt, sofern sie für die Aufgabe nicht gebraucht werden. Vor einer echten Eingabe sind außerdem die Datenschutz- und Aufbewahrungsbedingungen des gewählten Tarifs zu prüfen.
Dieselbe Grundlage verwenden. Wenn Claude und ChatGPT verglichen werden, sollten beide Systeme dieselben bereinigten Dateien, dieselbe Aufgabenbeschreibung und vergleichbare Werkzeuge erhalten. Unterschiede bei Websuche oder Dateizugriff werden notiert, denn sie können das Ergebnis mitbestimmen.
Vorab Kriterien festlegen. Für Verträge zählen etwa korrekte Fundstellen und ausgelassene Abweichungen. Für Zahlen zählen nachvollziehbare Formeln, korrekt übernommene Werte und ein Hinweis auf fehlende Daten. Verständlichkeit kann ebenfalls bewertet werden, sollte aber nicht Genauigkeit ersetzen.
Ergebnisse am Original prüfen. Jede wichtige Vertragsaussage wird in der genannten Passage nachgeschlagen. Summen werden unabhängig in einer Tabellenkalkulation nachgerechnet. Ein plausibel klingender Text gilt nicht allein deshalb als korrekt.
Dieses Vorgehen ist ein Vorschlag für einen eigenen Vergleich, kein hier ausgeführter Test. Wenn sich die Modelle bei einem Lauf unterscheiden, sollte man dieselbe Aufgabe noch einmal mit einer kleinen Variation prüfen. Einzelne Antworten können zufällig besser oder schlechter ausfallen; bei wichtigen Geschäftsentscheidungen ist deshalb ein reproduzierbares Prüfverfahren aussagekräftiger als ein kurzer Chat.
Woran erkennt man ein brauchbares Ergebnis – und wann sollte man den Ansatz ändern?
Ein brauchbares Ergebnis für das fiktive Unternehmen wäre nicht einfach eine flüssige Zusammenfassung. Es müsste konkrete Vertragsstellen nennen, Unsicherheiten kenntlich machen und Rechenschritte so beschreiben, dass sie unabhängig nachprüfbar sind. Fehlen Seitenangaben, stimmen Zahlen nicht mit der Quelldatei überein oder erfindet das Modell eine Klausel, sollte man den Auftrag enger fassen: erst eine einzelne Datei bearbeiten lassen, die Fundstellen ausdrücklich verlangen und Summen separat prüfen.
Wenn ein langes Dokument teilweise unberücksichtigt bleibt, kann man es in Abschnitte teilen und zunächst ein Inhaltsverzeichnis der relevanten Fragen erstellen lassen. Das ist oft leichter zu kontrollieren, kostet jedoch zusätzliche Zeit und kann Zusammenhänge zwischen weit entfernten Klauseln verdecken. Ein großes Kontextfenster senkt daher nicht automatisch den Prüfaufwand und ersetzt kein fachliches Urteil.
Für aktuelle Preise, Lieferbedingungen oder neue Gesetze sollte man außerdem eine aktuelle, verlässliche Quelle heranziehen. Ein Modellwissenstand ist nicht dasselbe wie eine Live-Recherche. Anthropic nennt für Opus 5.5 einen Trainingsdatenstand bis Juni 2026; für spätere Änderungen ist eine Prüfung aktueller Dokumente nötig. Das Unternehmen beschreibt diesen Stand in seiner Hilfe zum Aktualitätsstand der Claude-Modelle.
Fazit: Erst die Aufgabe, dann das Modell auswählen
Opus 5.5 ist ein neu angekündigtes Anthropic-Modell mit offiziell beschriebenen Schwerpunkten bei Programmierung, Computerbedienung und Wissensarbeit. Die genannten Kontext- und API-Werte sind relevant, wenn sie zum eigenen Zugang und Arbeitsablauf passen. GPT-5.6 Sol überschneidet sich laut OpenAI bei mehreren anspruchsvollen Einsatzfeldern. ChatGPT und Claude wiederum sind Dienste, deren Funktionen, Preise und Modellzugänge vom Plan und Rollout abhängen.
Für die hypothetische Vertrags- und Tabellenprüfung wäre die beste Wahl daher diejenige, die mit den freigegebenen Materialien nachvollziehbare Fundstellen und prüfbare Rechnungen liefert – und deren Grenzen im genutzten Tarif klar sind. Der Selbstcheck ist einfach: Stimmen Belege und Zahlen mit den Originalen überein, sind Unsicherheiten sichtbar, und kann eine Person das Ergebnis ohne blinden Vertrauensvorschuss freigeben? Wenn nicht, muss der Auftrag enger werden oder die entscheidende Prüfung bei einem Menschen bleiben.