Startseite
» Gewusst wie
»
Diagnose eines SUSE-Servers, der beim Herunterfahren mit systemd hängen bleibt
Diagnose eines SUSE-Servers, der beim Herunterfahren mit systemd hängen bleibt
Wenn sich SUSE Linux Enterprise Server während des Herunterfahrens durch systemd aufhängt, identifizieren Sie die Unit mit einem laufenden Stoppvorgang oder überprüfen Sie die letzten Meldungen des vorherigen Systemstarts. Beheben Sie anschließend das Problem mit dieser Unit oder ihrer Abhängigkeit. Eine Unit ist eine von systemd verwaltete Ressource, wie z. B. ein Dienst oder ein Mountpunkt; ein Stoppvorgang ist eine Aufforderung von systemd, eine solche Ressource zu beenden. Reduzieren Sie nicht als erste Maßnahme ein globales Timeout oder erzwingen Sie ein erzwungenes Herunterfahren, da ein Dienst oder ein Dateisystem möglicherweise noch Dateien schließt oder Daten schreibt.
Diese Anleitung orientiert sich an der SLES 15 SP7-Dokumentation (Stand: Oktober 2026). Die genaue Vorgehensweise zum Stoppen von Diensten hängt vom jeweiligen Dienst- und Speicheranbieter ab. Beachten Sie daher deren Vorgaben für alle gerätespezifischen Änderungen.
1. Den Abschaltvorgang sicher beobachten.
Schritt 1: Notieren Sie die genaue Nachricht und warten Sie auf hilfreiche Beweise.
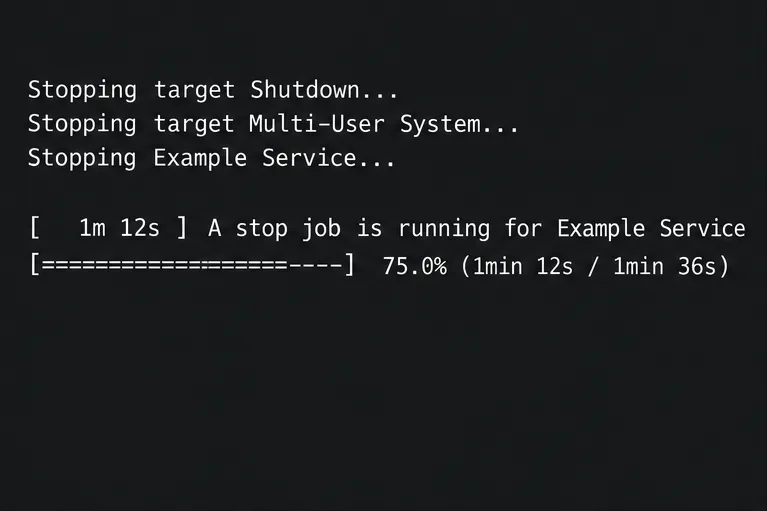
Wenn in der Konsole „Ein Stoppvorgang läuft für …“ mit einem Countdown angezeigt wird, notieren Sie sich den angegebenen Dienst oder Mountpunkt und ob sich der Timer ändert. Dies bedeutet, dass systemd auf den Stoppvorgang dieser Einheit wartet, nicht unbedingt, dass das Betriebssystem abgestürzt ist; Datenbanken und entfernte Speicher benötigen möglicherweise Zeit, um ordnungsgemäß heruntergefahren zu werden.
Eine Beispiel-Konsolenmeldung nennt die Einheit, auf die systemd wartet; der angezeigte Dienst und der Countdown dienen nur der Veranschaulichung.
Beobachten Sie den Vorgang über eine Remote- oder serielle Konsole oder ein anderes verfügbares Terminal. Vermeiden Sie Reset- oder Power-Befehle, solange Schreibvorgänge laufen. Wenn das System nicht mehr reagiert, notieren Sie die letzte sichtbare Zeile und fahren Sie nach dem Neustart fort.
2. Finde die Einheit, die wartet.
Schritt 2: Überprüfen Sie die systemd-Jobs, falls der Rechner noch Befehle annimmt.
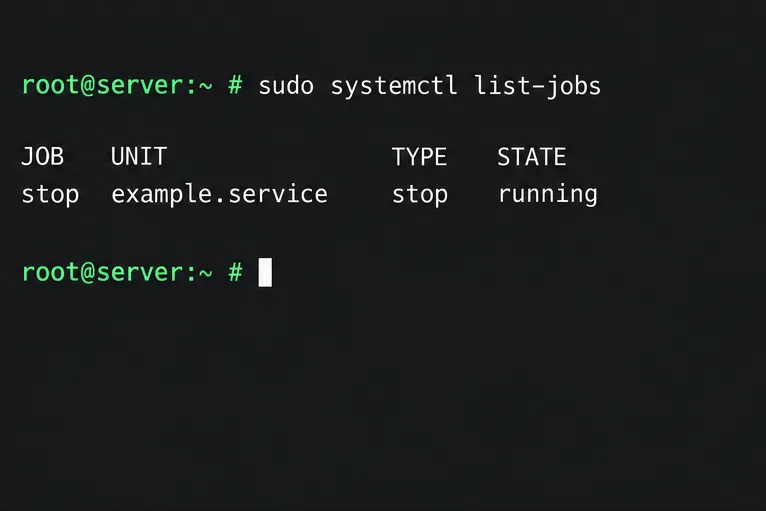
Falls SSH oder ein zweites Terminal noch funktioniert, fragen Sie systemd, welche Jobs ausgeführt werden oder warten, und überprüfen Sie dann die auf dem Bildschirm angezeigte Unit:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service
In der Aufgabenliste kann ein Dienst identifiziert werden, dessen Stoppvorgang noch läuft; die angezeigte Zeile ist ein Beispiel.
Ersetzen Sie dies SERVICEdurch den tatsächlichen Unit-Namen. Ein laufender Stopp-Job schränkt die Suche zwar ein, erklärt aber nicht, warum der Prozess nicht beendet wurde. Lesen Sie Status und Protokolle, bevor Sie die Konfiguration ändern. Wenn systemd nicht mehr antwortet, brechen Sie Jobs nicht einfach ab; prüfen Sie das vorherige Journal, nachdem der Host wieder reagiert.
3. Verwenden Sie den vorherigen Bootvorgang, um die Ursache zu ermitteln.
Schritt 3: Lesen Sie das Ende des Protokolls des vorherigen Bootvorgangs.
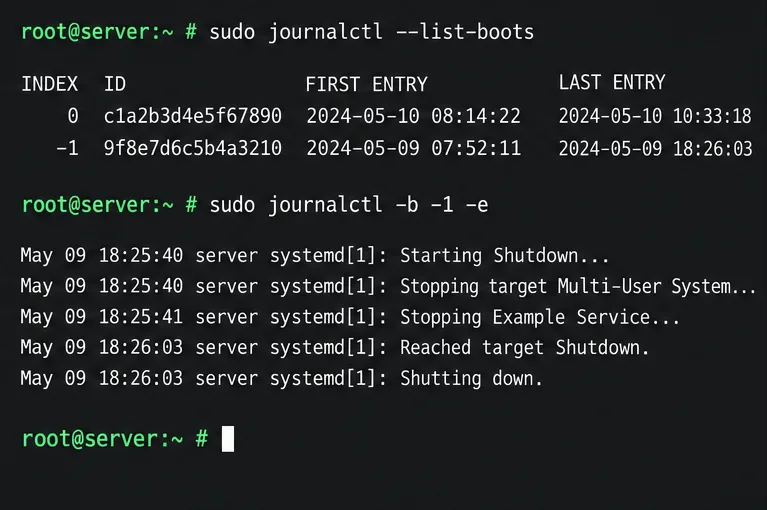
Das Journal ist das von systemd indizierte Protokoll der Kernel-, Dienst- und Systemmeldungen. Nach dem nächsten erfolgreichen Start listen Sie die aufgezeichneten Startvorgänge auf und überprüfen Sie das Ende des vorherigen Eintrags:
Der -1Offset wählt den vorhergehenden Bootvorgang aus und -espringt zu dessen letzten Einträgen.
Achten Sie auf die letzte Meldung „Wird beendet“, einen Timeout, Wiederholungsversuche oder einen Gerätenamen bzw. eine Mount-Nummer. Die letzte Zeile ist nur ein Hinweis: Die Herunterfahrreihenfolge kann dazu führen, dass ein anderes Gerät im Hintergrund wartet. Vergleichen Sie die Zeitstempel und die Meldungen in der Nähe.
Schritt 4: Protokolle nach dem verdächtigen Dienst filtern
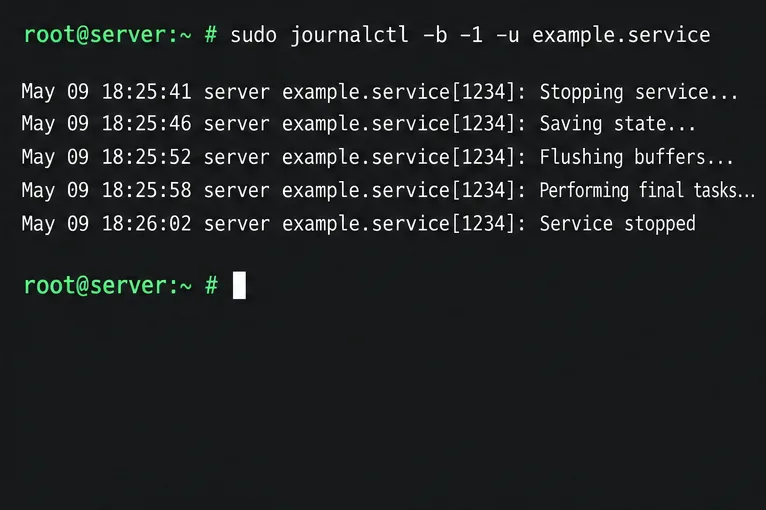
Wenn auf dem Bildschirm oder im Journal ein Dienst genannt wird, fragen Sie nur die Einträge des vorherigen Systemstarts dieser Einheit ab. Überprüfen Sie auch deren geladene Konfiguration:
Durch das Filtern nach Einheiten lässt sich eine langsame Dienstabschaltung von nicht damit zusammenhängenden Meldungen an anderer Stelle im Journal unterscheiden.
Prüfen Sie, ob ein benutzerdefinierter Code ExecStop, ein Skript, das unbegrenzt wartet, ein verbleibender Kindprozess oder ein Anwendungsfehler im Shutdown-Hook vorliegt. Vergleichen Sie bei Geräten von Drittanbietern das Paket und die Konfiguration mit den offiziellen Richtlinien, bevor Sie Änderungen vornehmen.
Schritt 5: Überprüfen Sie Halterungen und Aufbewahrungsmöglichkeiten nur dann, wenn die Indizien darauf hindeuten.
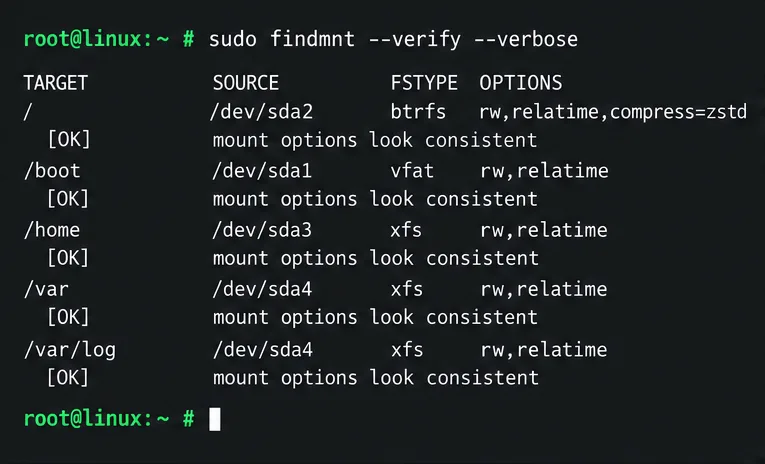
Wenn das Journal einen Mountpunkt, ein Gerät oder ein entferntes Dateisystem nennt, überprüfen Sie die Mount-Tabelle und den entsprechenden Eintrag in /etc/fstab:
sudo findmnt --verify --verbose
Verwenden Sie die Mount-Verifizierung, wenn Protokolle auf einen Mount hinweisen; die angezeigten Einträge dienen nur der Veranschaulichung und müssen mit dem Host abgeglichen werden.
Prüfen Sie, ob eine NFS-, CIFS-, iSCSI- oder andere Remote-Abhängigkeit während des Herunterfahrens erreichbar und erwartet ist. Entfernen Sie einen veralteten Mount-Eintrag erst, nachdem Sie sichergestellt haben, dass er nicht mehr verwendet wird. Hängen Sie ein aktives Dateisystem nicht zwangsweise aus, nur weil der Neustart langsam ist.
4. Beheben Sie die Ursache, ohne sie zu verheimlichen.
Schritt 6: Reparieren Sie den Dienst oder passen Sie nur seine dokumentierte Stopprichtlinie an.
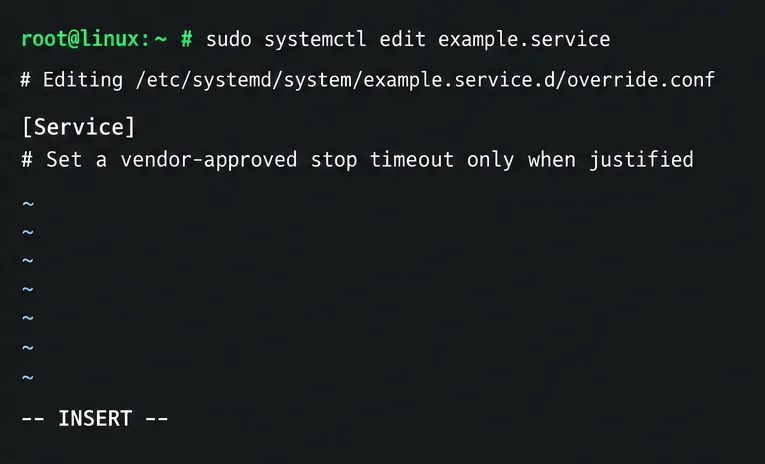
Wenn ein Dienst nicht beendet wird, beheben Sie zuerst das Problem mit dem Beendigungsskript, der Anwendungskonfiguration oder dem Paket. Eine pro Einheit verfügbare Drop-in-Datei wird ohne Bearbeitung der Herstellerdatei sudo systemctl edit SERVICE.servicegespeichert . SUSE-Dokumente für das Starten und Beenden von Diensten; verwenden Sie für diese Arbeitslast einen vom Hersteller freigegebenen Wert./etc/systemd/system/TimeoutSec
Eine einzelne Einheit kann eine gezielte Überschreibung enthalten; der angezeigte Hinweis dient als Orientierungshilfe und ist kein Zeitüberschreitungswert.
Nach einer dokumentierten Änderung laden Sie die Unit-Definitionen von systemd neu sudo systemctl daemon-reloadund überprüfen Sie das Ergebnis sudo systemctl cat SERVICE.service. Ein längeres Timeout ermöglicht zwar ein ordnungsgemäßes Herunterfahren, kann aber auch einen fehlgeschlagenen Neustart verlängern. Ein kürzeres Timeout kann dazu führen, dass ein Dienst beendet wird, bevor er seinen Zustand aktualisiert hat. Ändern Sie keine globalen Standardeinstellungen, um den Fehler einer einzelnen Unit zu kaschieren.
Schritt 7: Protokolle für den nächsten Vorfall aufbewahren
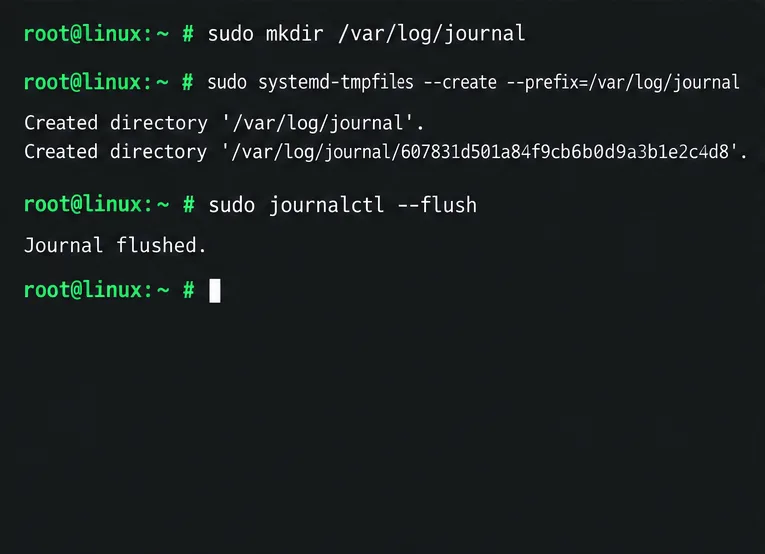
SLES speichert Journaldaten /run/log/journal/standardmäßig unter einem flüchtigen Verzeichnis, das beim Neustart gelöscht wird. Falls journalctl -b -1keine Einträge vom vorherigen Systemstart vorhanden sind, aktivieren Sie die dauerhafte Speicherung des Journals für zukünftige Diagnosen.
Diese Befehle erhalten neue Journaleinträge auch nach Neustarts aufrecht; bereits aus dem flüchtigen Speicher verlorene Protokolle können sie nicht wiederherstellen.
Persistente Protokolle belegen Speicherplatz unter /var; SUSE weist darauf hin, dass das Journal standardmäßig bis zu 10 Prozent dieses Dateisystems belegen kann. Überprüfen Sie den freien Speicherplatz und die Aufbewahrungsdauer, insbesondere bei kleinen /varDatenträgern.
5. Überprüfen Sie den nächsten geplanten Neustart.
Schritt 8: Bestätigen Sie, dass der Stoppvorgang abgeschlossen ist und der Server wieder in Betrieb genommen wurde.
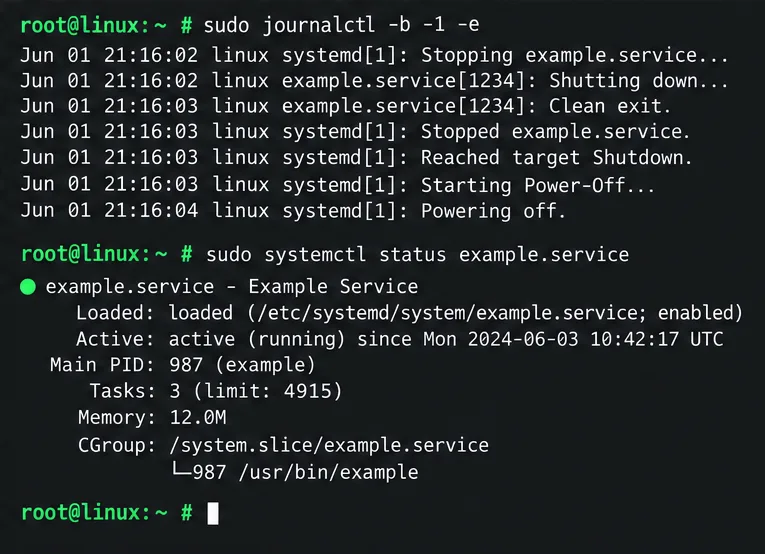
Sobald die vermutete Ursache behoben ist, planen Sie einen kontrollierten Neustart mit verfügbarem Konsolenzugriff. Überprüfen Sie nach dem Neustart die letzten Meldungen des vorherigen Neustarts und den aktuellen Status des Dienstes.
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service
Überprüfen Sie nach einem späteren Neustart, ob der vorherige Herunterfahrvorgang seine letzten Meldungen erreicht hat und der Dienst wieder betriebsbereit ist; dies ist eine Beispielansicht, kein Testnachweis.
Das Problem ist behoben, wenn der Server ohne Wartezeit auf demselben Gerät herunterfährt, normal hochfährt und der Dienst bzw. die Einbindung funktioniert. Falls die Protokolle abrupt enden oder Kernel-, Controller- oder Hardwarefehler aufweisen, sollten diese aufbewahrt und mit SUSE oder dem Hardwarehersteller untersucht werden, anstatt Timeout-Einstellungen anzupassen.
Detaillierte Befehlsinformationen finden Sie im SLES 15 SP7 systemd-Leitfaden und im SUSE-Leitfaden zu persistenten Journalen und journalctl-Filtern . Diese Schritte identifizieren mögliche Blockierer; die richtige Lösung – sei es ein Dienst, ein Dateisystem oder eine Hardwarekomponente – hängt von der Einheit ab, die in den Protokollen des Systems selbst angegeben ist.